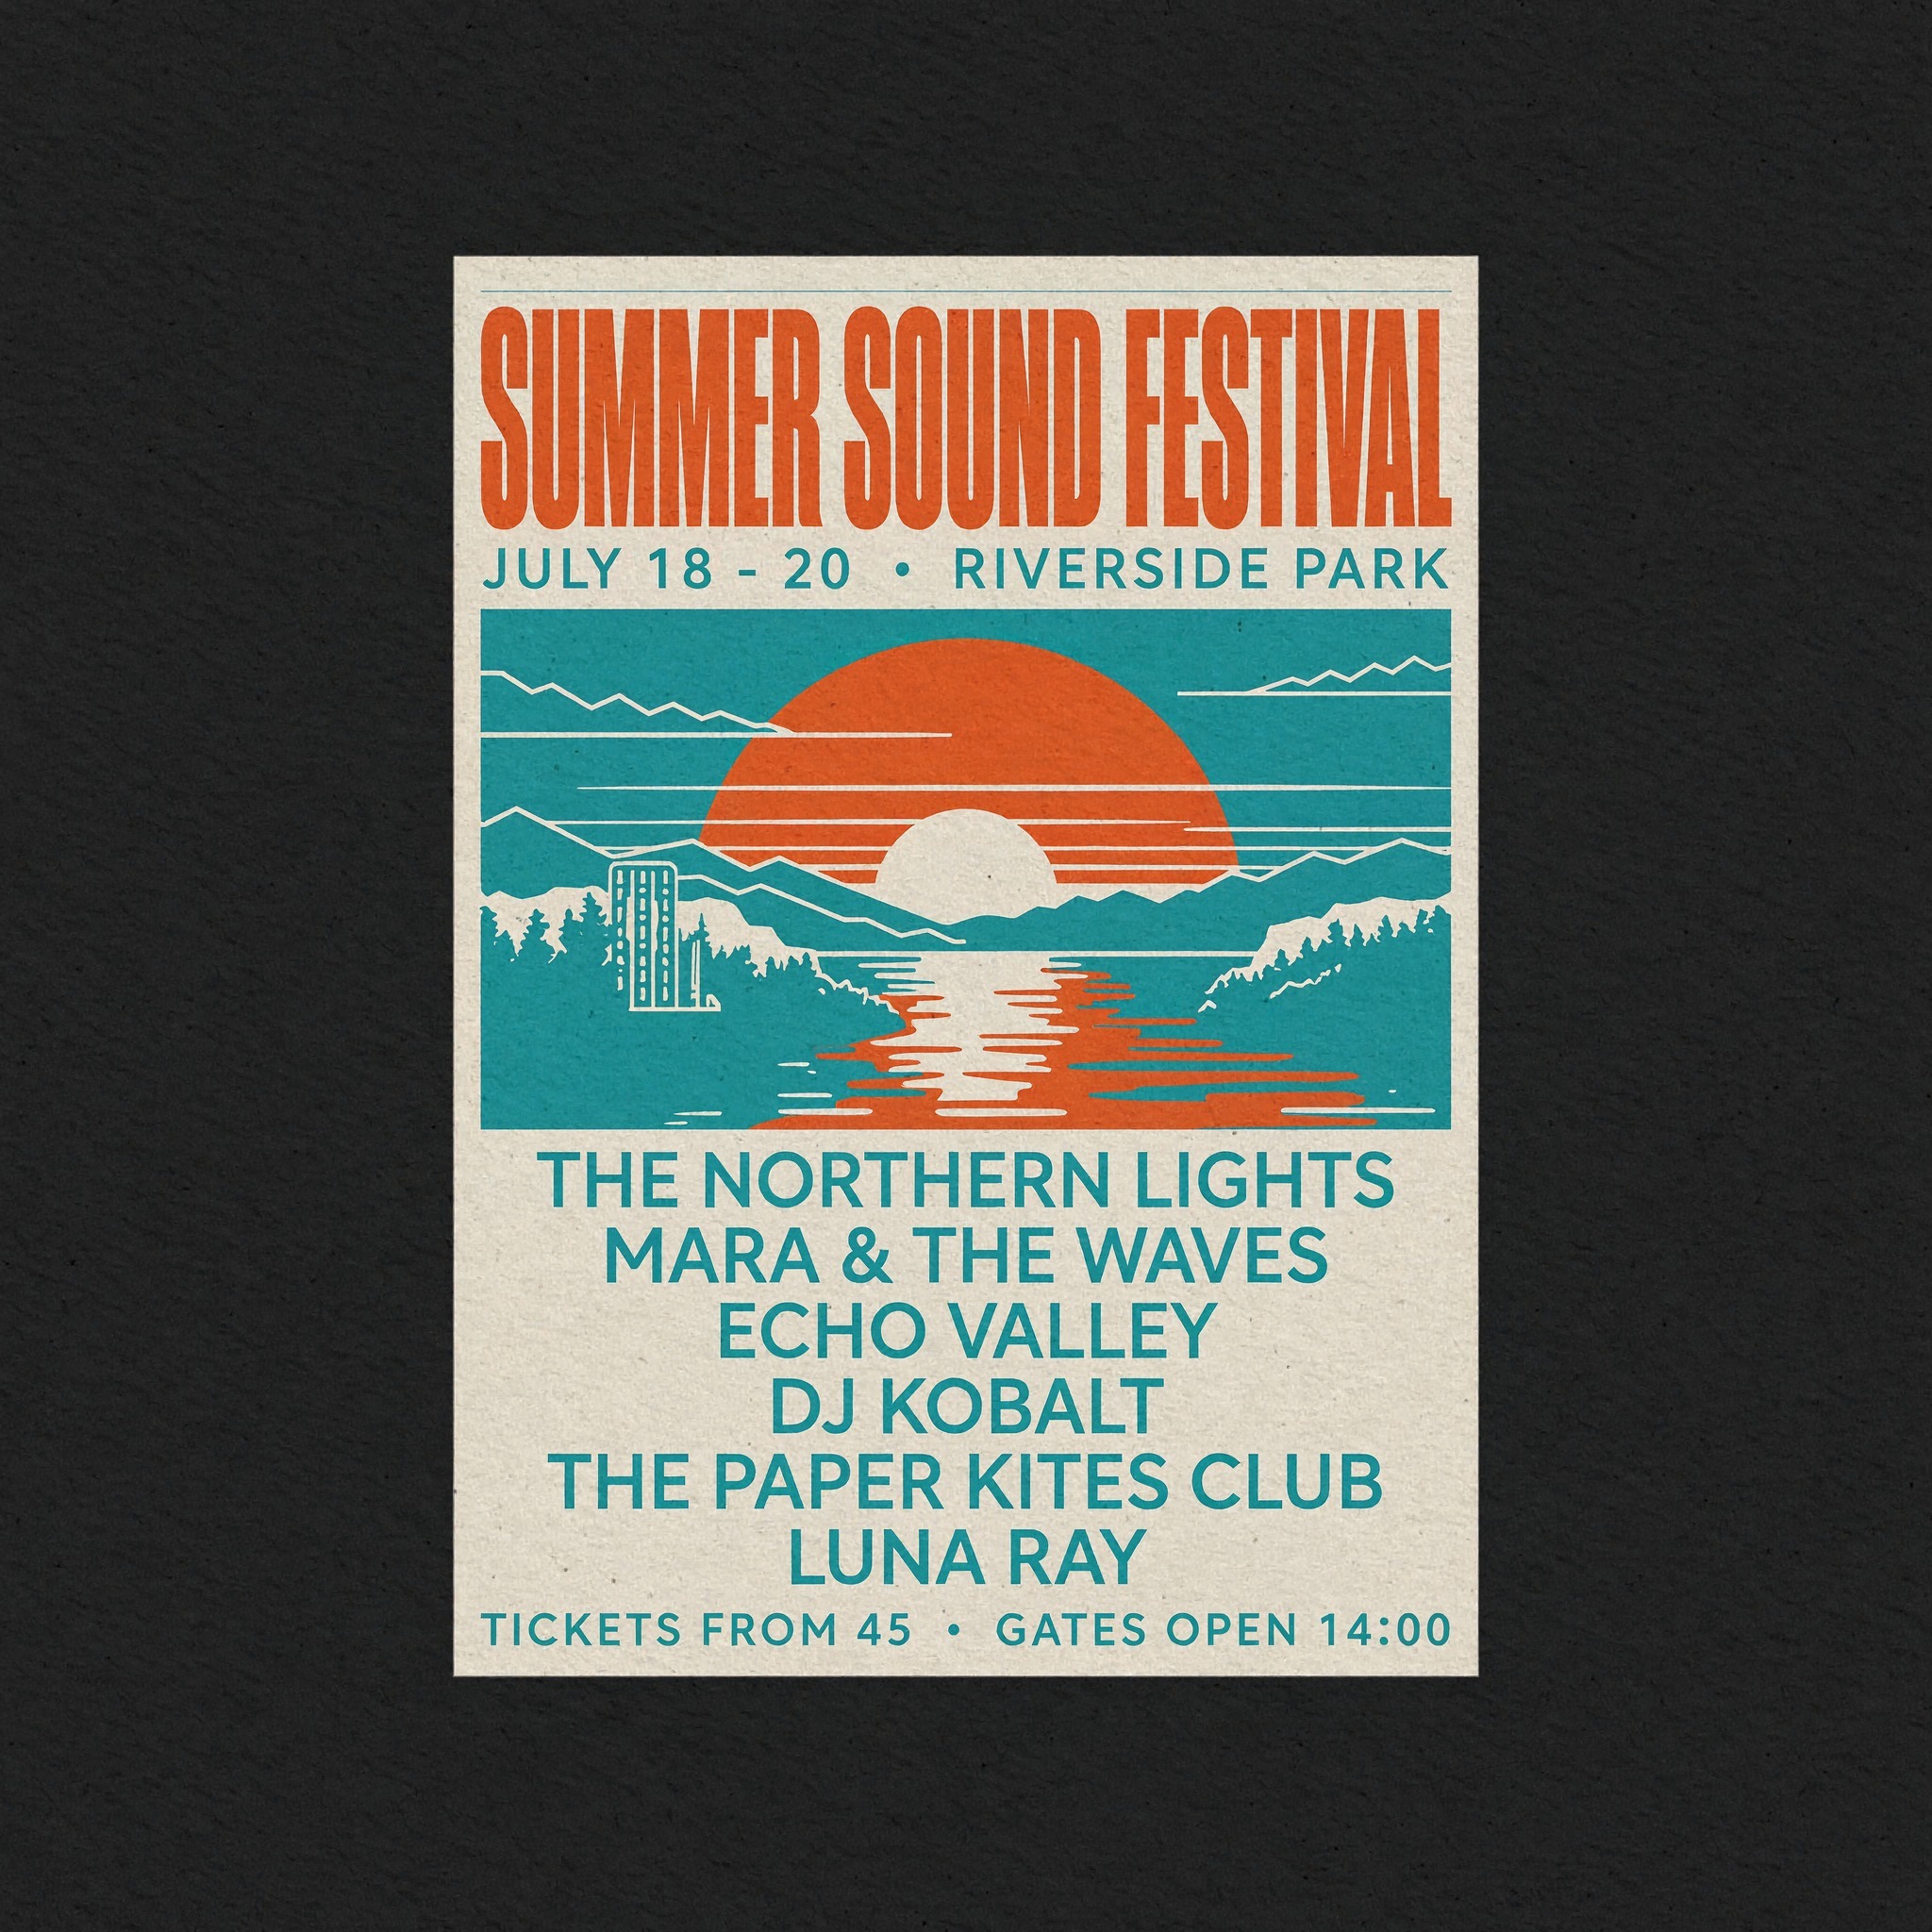
Bovenaan: een concertposter in zeefdrukstijl, gemaakt door MiniMax-H3-Image op één R9700. Alle bandnamen, de datums en de ticketregel zijn correct gespeld.
MiniMax-H3-Image draait nu op één AMD Radeon AI PRO R9700 van 32 GB. Een afbeelding van 2048 x 2048 duurt 6,9 s en een afbeelding van 4096 x 4096 duurt 33,4 s, met de vermogenslimiet van de kaart op 300 W. De FP8-gewichten staan op Hugging Face en de container staat in onze paiton-vllm-plugin-repository.
De gewichten die voor inferentie nodig zijn, nemen op hun oorspronkelijke precisie ongeveer 120 GB in: het beeldcheckpoint en de eerste 50 lagen van de tekstencoder. Dat is niet de downloadgrootte van het volledige model met alle tekstencoderlagen. Hieronder leggen we uit wat het model doet, waarom het niet op een R9700 past, wat we hebben gebouwd om dat mogelijk te maken en hoe we de beelden met het origineel hebben vergeleken.
De voorbeeldafbeeldingen zijn gegenereerd in een afgeschermde R9700-testomgeving. Dit artikel gaat over de optimalisatie van de uitvoering van het model.
In dit artikel: het model, geheugen, de runtime, snelheid, kwaliteit, voorbeelden, beperkingen, zelf proberen en de licentie.
Wat MiniMax-H3-Image is
MiniMax-H3-Image is MiniMax' model met openbaar beschikbare gewichten voor het genereren en bewerken van afbeeldingen. Drie eigenschappen vallen op tegenover de andere open beeldmodellen die we tot nu toe hebben gedraaid.
Het maakt grote afbeeldingen rechtstreeks. MiniMax geeft een werkbereik van 4 tot 20 MP en zegt dat het model het best werkt rond 16 MP, bijvoorbeeld 4096 x 4096 (1:1) of 5472 x 3072 (16:9), zonder upscaler in de pipeline. MiniMax vergelijkt dat met de 1 tot 4 MP die vandaag gebruikelijk is bij open modellen.
Het heeft maar 6 samplingstappen nodig, zonder classifier-free guidance. Het checkpoint is gedistilleerd tot zes transformerpasses per afbeelding. Veel andere modellen gebruiken 20 tot 50 stappen en twee passes per stap wanneer guidance aanstaat.
Eén checkpoint kan zowel afbeeldingen genereren als bewerken, met maximaal 16 referentieafbeeldingen. Het model is ook goed in tekst binnen afbeeldingen: op posters, borden, menu's en handgeschreven notities is de spelling in de meeste van onze tests correct.
De architectuur is een single-stream diffusion transformer met 33,1 miljard parameters, 50 blokken, een hidden size van 5376 en 56 attention heads. De prompt en eventuele referentieafbeeldingen gaan door een Qwen3-VL-tekstencoder; de referentieafbeeldingen gaan ook door de beeld-VAE. Alles wordt daarna samengevoegd tot één tokenreeks. Bij 16 MP telt die ongeveer 16.400 tokens, en elk blok voert volledige attention uit over de hele reeks.
Waarom het niet op een R9700 past
De transformergewichten zijn BF16. Het beeldcheckpoint is 68,65 GB, inclusief de VAE; de transformerbestanden zelf zijn 66,28 GB. De eerste 50 lagen van de Qwen3-VL-tekstencoder van 32 miljard parameters voegen ongeveer 52 GB toe. De R9700 heeft 32 GB.
| Configuratie | Onderdeel | Geheugen |
|---|---|---|
| Oorspronkelijke precisie | Beeldcheckpoint, inclusief VAE | 68,7 GB |
| Oorspronkelijke precisie | Eerste 50 tekstencoderlagen | 52,0 GB |
| Oorspronkelijke precisie | Werkgewichten samen | 120,7 GB |
| Paiton | FP8-transformergewichten op de GPU | 20,3 GB |
| Paiton | Activaties, VAE en tekstencoderlagen op de GPU | 9,3 GB |
| Paiton | Piek op de GPU | 29,6 GB |
De 24,4 GB aan tekstencoderlagen in vastgezet hostgeheugen is niet inbegrepen in het GPU-totaal. De oorspronkelijke werkgewichten en de piek van de Paiton-runtime zijn verschillende grootheden: de Paiton-piek omvat ook activaties.
Het laden van de BF16-gewichten op de kaart stopt vóór de eerste stap. Ze naar het systeemgeheugen verplaatsen zou bij elk van de zes stappen tientallen gigabytes over PCIe sturen; die aanpak hebben we niet geprobeerd. MiniMax raadt onder meer SGLang, vLLM-Omni, diffusers en ComfyUI aan voor lokaal gebruik. Die kunnen het BF16-checkpoint laden.
Ook gewone FP8 is op zichzelf niet genoeg. Een FP8-transformer en een FP8-tekstencoder komen samen op ongeveer 47 GB.
Wat we hebben gebouwd
We hebben een native runtime geschreven voor de tekstencoder, transformer en VAE, met een HTTP-server die dezelfde verzoeken aanneemt als MiniMax' eigen voorbeelden. Het model draait in HIP en C++ op de kernels van Paiton, zonder PyTorch of Triton. De containerimage is 2,27 GB.
AdaLN-tabellen in plaats van AdaLN-gewichten
Elk transformerblok heeft een modulatieprojectie (AdaLN) die de timestep omzet in schalingen en verschuivingen voor dat blok. Over de 50 blokken bevatten die projecties ongeveer 13 miljard van de 33,1 miljard parameters. Hun enige invoer is de timestep. Het gedistilleerde model gebruikt altijd dezelfde zes timesteps. Daarom voeren we de projecties vooraf één keer uit voor die zes waarden en slaan we de resultaten op in kleine tabellen. Het resultaat is exact, en 13 miljard parameters hoeven nooit naar de GPU. Er blijven 19,3 miljard parameters op de kaart over.
FP8-gewichten en -activaties, afgerond met GPTQ
De overige projecties draaien in FP8 E4M3: één schaal per uitvoerkanaal voor de gewichten en één per token voor de activaties. Daardoor lopen de matrixvermenigvuldigingen op de FP8-eenheden van de R9700. De transformer neemt 20,3 GB in.
We hebben verschillende manieren geprobeerd om de FP8-gewichten te kiezen, met BF16-activaties als referentie. SmoothQuant en clipping op basis van de gemiddelde kwadratische fout leverden niets op voor FP8 E4M3. Afronden met GPTQ verminderde de fout van elke matrixvermenigvuldiging met 19 tot 31% tegenover gewoon afronden. Dat gebruiken we in de release. Een variant met 4-bitsgewichten draaide even snel, maar had dubbel zoveel fout. Daarom hebben we FP8 behouden.
Een tekstencoder die uit het hostgeheugen streamt
De 50 lagen van de tekstencoder zijn ook FP8 en nemen samen 24,4 GB in. Ze staan in vastgezet hostgeheugen en worden voor elk verzoek naar de kaart gekopieerd. Als er ruimte is, blijven maximaal 12 lagen op de kaart staan. De encoder draait één keer per afbeelding en kost 0,7 tot 0,9 s per verzoek.
Zo dicht tegen de geheugenlimiet van de kaart werken veroorzaakte één probleem. In vroege tests vielen 3 van de 54 denoisingstappen stil doordat de GPU-driver onze buffers uit het bijna volle VRAM verwijderde. Een limiet van 27,5 GiB voor de runtime verholp dat: 0 van de 60 stappen vielen nog stil.
Attention en de VAE
Attention gebruikt INT8 voor Q en K en FP8 voor P en V. In afzonderlijke tests was het laatste transformerblok daar het gevoeligst voor. Daarom hebben we exacte attention voor individuele blokken getest. Over de volledige pipeline kwamen de afbeeldingen daarmee niet dichter bij BF16 uit, dus gebruikt elk blok de kernel met lagere precisie. De VAE-decoder gebruikt INT8-gewichten en decodeert tegels van 256 px, met dezelfde overlap en blending als de referentie.
Waar de tijd naartoe gaat
Elk van de zes stappen is één HIP graph. Bij 16 MP duurt een stap ongeveer 5,2 s. In ons profiel namen de projectie-GEMMs ongeveer 3,0 s per stap in, op 65 tot 68% van de FP8-piek van de kaart. Attention nam ongeveer 2,3 s in. De tekstencoder voegt 0,7 tot 0,9 s per verzoek toe en de VAE-decoder ongeveer 0,75 s bij 16 MP. Het piekgeheugengebruik is 27,6 GiB.
Snelheid
| Verzoek | Formaat | Referentieafbeeldingen | Tijd |
|---|---|---|---|
| Genereren uit tekst | 2048 x 2048 | 0 | 6,9 s |
| Genereren uit tekst | 4096 x 4096 | 0 | 33,4 s |
| Bewerken | 4096 x 4096 | 1 | 39,9 s |
| Bewerken | 4736 x 3552 | 1 | 50,1 s |
| Bewerken | 4096 x 4096 | 3 | 88,5 s |
Eén R9700, vermogenslimiet van 300 W, zes stappen. Gepubliceerde metingen · Afbakening van de meting · Grafiekdata.
De tijden meten de native modelpipeline tot de afgewerkte PNG, inclusief het verkleinen van de uitvoer wanneer dat nodig is. De server is opgewarmd en de vermogenslimiet van de kaart staat op 300 W. Het voorverwerken van het verzoek, wachten in de wachtrij en het overdragen van het antwoord vallen buiten de meting.
Afbeeldingen kleiner dan 4 MP worden op een canvas van 4 MP gemaakt en daarna verkleind, zoals in MiniMax' pipeline. Daarom duurt een verzoek voor 1024 x 1024 ongeveer 7,1 s. Elke referentieafbeelding voegt tokens toe aan de reeks, waardoor bewerkingen langer duren.
Kwaliteit
We hebben onze build op 30 gevallen vergeleken met het BF16-model in diffusers: 24 tekstprompts van 4 tot 17 MP in verschillende beeldverhoudingen en 6 bewerkingen met 1 tot 3 referentieafbeeldingen. Beide gebruikten dezelfde token-ID's en dezelfde startruis, zodat verschillen uit de numerieke berekeningen komen.
| Maatstaf | BF16 | Onze FP8-build |
|---|---|---|
| CLIP-L-score voor tekst-beeld, gemiddelde | 32,31 | 32,18 |
| CLIP-L-gelijkenis met het BF16-beeld, gemiddeld / laagst | 0,979 / 0,855 | |
| DINOv2-gelijkenis met het BF16-beeld, gemiddeld / laagst | 0,945 / 0,699 |
De tekst-beeldscore valt binnen de spreiding tussen de testgevallen. De meeste verschillen zitten in de compositie: bij zes samplingstappen kunnen kleine numerieke veranderingen het traject wijzigen. Sommige afbeeldingen zijn daardoor anders opgebouwd, terwijl ze dezelfde inhoud tonen. Tekst, gezichten en productfoto's werden in deze tests correct weergegeven.
Bewerkingen blijven het dichtst bij BF16, met een beeldgelijkenis van 0,96 tot 0,999.
Meer voorbeelden
Alle voorbeelden zijn gemaakt met de vrijgegeven gewichten op 4096 x 4096, in ongeveer 34 s per afbeelding. Hier worden ze verkleind tot 2048 x 2048 getoond. Voor elke prompt kozen we de beste van twee seeds.
Niet alles lukt. Kleine lopende tekst, zoals de krantenkolommen en sommige boekruggen, lijkt vanop afstand op schrift maar bestaat niet uit echte woorden. Handen in close-up, een klok die op drie uur moest staan en een paard dat op de rug van een astronaut moest rijden, kwamen in onze tests verkeerd uit.
Beperkingen van deze build
- Prompts zijn beperkt tot 4.096 tokens. Elke referentieafbeelding van 1024 px gebruikt er ongeveer 1.000, dus een bewerking kan ongeveer drie referenties aan, niet de 16 van het model. Een hogere limiet vraagt meer geheugen voor de tekstencoder; hoeveel hebben we niet gemeten.
- Het grootste canvas is 16,8 MP (4736 x 3552). MiniMax' 21:9-formaat rond 16 MP (6272 x 2688) is iets groter en past niet naast de gewichten.
- Verzoeken worden één voor één uitgevoerd.
- De host heeft 64 GB RAM nodig, omdat de tekstencoder uit vastgezet geheugen streamt, en 48 GB schijfruimte voor de gewichten.
- Dezelfde seed geeft dezelfde ruis als de diffusers-pipeline, met hoogstens een verschil in het laatste bit van elke waarde. Afbeeldingen liggen daardoor dicht bij BF16-uitvoer met dezelfde seed, maar zijn niet bit-identiek.
Zelf proberen
U hebt een R9700, een ROCm-compatibele kerneldriver, Docker en Python 3 op de host nodig. Lees eerst de modellicentie en controleer welke toestemming voor uw gebruik nodig is.
git clone --depth 1 https://github.com/Eliovp-BV/paiton-vllm-plugin.git
cd paiton-vllm-plugin
./models/MiniMax-H3-Image/launch.sh
De eerste start downloadt 48 GB aan gewichten van Hugging Face en controleert elk bestand aan de hand van zijn SHA-256. De server neemt verzoeken aan zodra READY http://0.0.0.0:30000 verschijnt.
Open dan een tweede terminal in de map paiton-vllm-plugin om een afbeelding te genereren:
./models/MiniMax-H3-Image/run.sh generate "A red fox in fresh snow at sunrise" --size 4096x4096 --out fox.png
Of bewerk een bestaande afbeelding:
./models/MiniMax-H3-Image/run.sh edit "Make <Picture 1> a watercolor painting" --image photo.png --size 2048x2048 --out edit.png
De handleiding beschrijft de volledige API en de instellingen.
Licentie
Het model valt onder de MiniMax-H3-Image Community License. Die geldt niet in de Europese Unie, het Verenigd Koninkrijk, de Republiek Korea of de Verenigde Staten. De territoriale beperkingen gelden ook voor het gebruiken, verspreiden en tonen van gegenereerde uitvoer.
Commerciële producten en diensten die het model gebruiken, moeten "MiniMax-H3-Image" duidelijk in hun gebruikersinterface tonen. Voor gehoste diensten aan derden is voorafgaande schriftelijke toestemming van MiniMax nodig. Dat geldt ook wanneer de op jaarbasis berekende omzet van de licentiehouder en/of verbonden ondernemingen hoger is dan US$1 miljoen.
Controleer vóór gebruik de volledige licentie en verkrijg de vereiste toestemming. Wij hebben geen controle over hoe anderen het model gebruiken en volgen dat ook niet.
Meer over de runtime vindt u op de Paiton-productpagina. Voor video met geluid op dezelfde kaart kunt u ons artikel over MiniMax H3 op de R9700 lezen.