We wilden weten hoeveel we uit één GPU konden halen. Steeds meer projecten vinden manieren om enorme modellen te draaien door een deel van de gewichten in systeemgeheugen of op schijf te bewaren, in plaats van alles in GPU-geheugen te moeten passen. Dat wilden we ook op CDNA4 onderzoeken.
We hadden al iets vergelijkbaars gedaan met Qwen3.8 Flash Next op twee Radeon AI PRO R9700's, waarbij minder gebruikte experts in systeemgeheugen bleven. Deze keer kozen we een compleet ander, veel zwaarder model: DeepSeek V4.1 Flash. De hardwaregrens was één MI350P, ondersteund door een stevige CPU-host, geen rack vol GPU's.
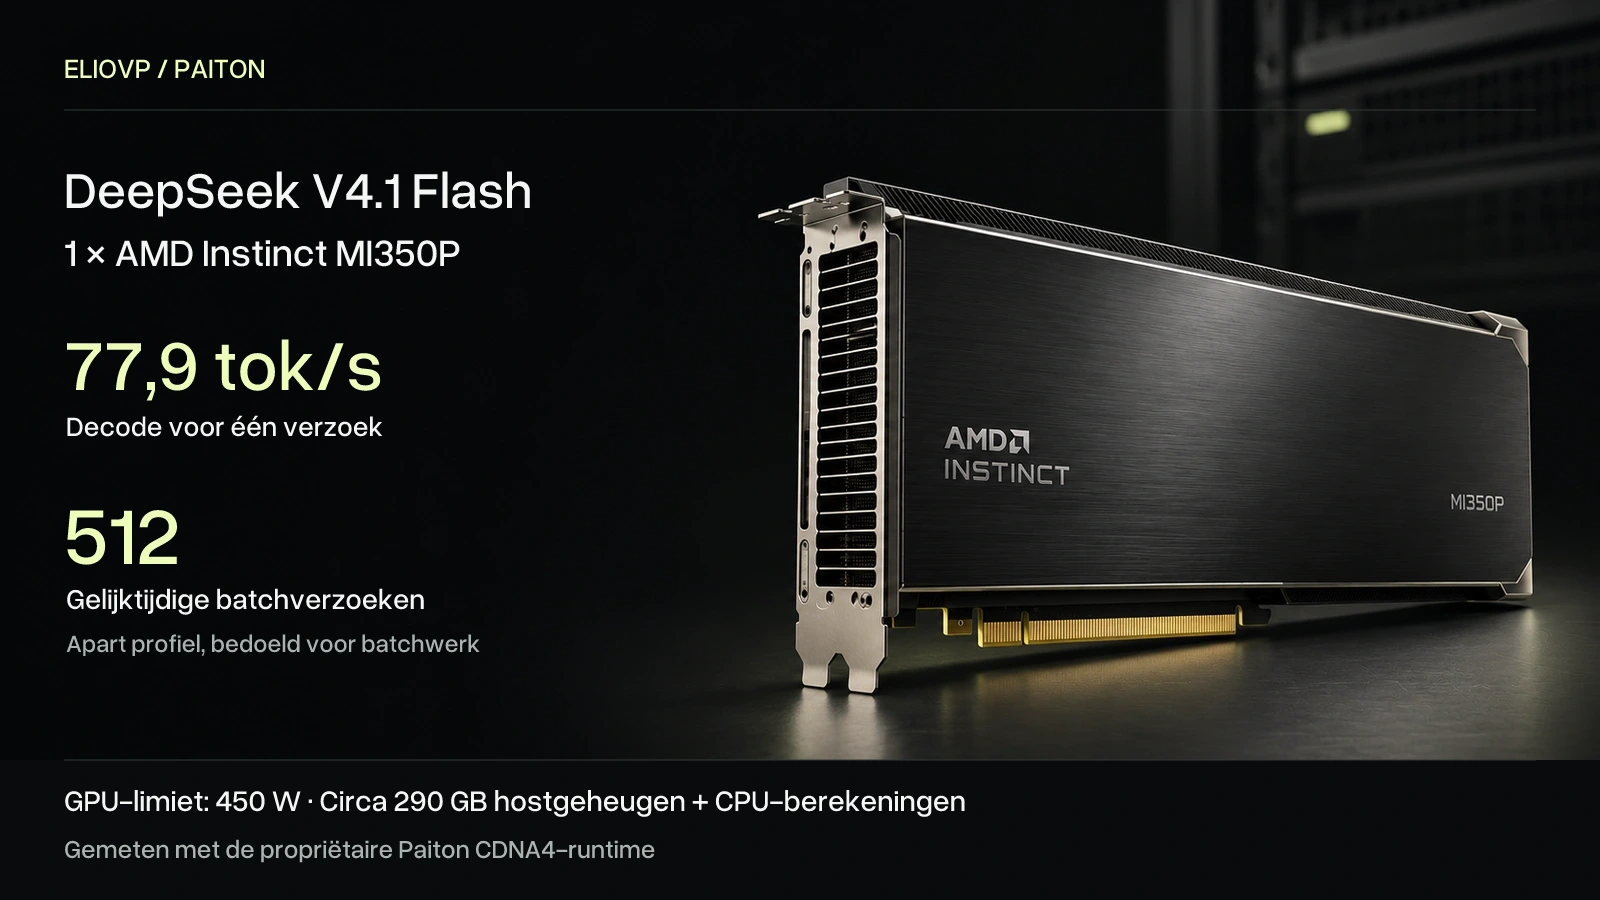
En we zijn behoorlijk blij met het resultaat. DeepSeek V4.1 Flash genereert met Paiton 77,9 tokens per seconde voor één verzoek op die ene MI350P. Bij 64 gelijktijdige verzoeken meet LocalMaxxing 709,6 tokens/s in totaal. Een afzonderlijk profiel voor batchverwerking haalt 1.107,6 uitvoertokens/s over 512 verzoeken met lange antwoorden.
In dit artikel
- Hardware en kwantisatie
- Servingprofielen en cachecapaciteit
- Decodesnelheid en prefill
- Vergelijking met de RTX PRO 6000
- RTX 5090, RTX 3090 en Mac Studio, plus configuraties met meerdere GPU's
- Gelijktijdige verzoeken, lange invoer en lange antwoorden
- Energieverbruik
- Nauwkeurigheid en terugzoektests
- Pogingen met standaard-vLLM en SGLang
- Gewichten, brondata en opname
- Bespreek je tokenfabriek
Dat laatste cijfer geldt voor batchwerk, niet voor vlotte chat. Elk verzoek genereert ongeveer 2,3 tokens/s nadat het mediaan drie minuten op zijn eerste token heeft gewacht. Alle MI350P-metingen gebruiken een GPU-vermogenslimiet van 450 W en een host met circa 290 GB aan modeldata in het geheugen. De CPU's berekenen de experts die niet op de GPU passen. “Eén GPU” betekent niet dat de GPU al het werk doet.
Het model is DeepSeek-V4.1-Flash-1017. Het oorspronkelijke checkpoint beslaat 475 GiB, veel meer dan de 144 GB HBM op deze kaart. Het resultaat komt dus van een andere opslag en uitvoering van het model, niet doordat het volledige oorspronkelijke model op de kaart past.
Paiton is ons framework voor AI-optimalisatie op AMD-hardware. Deze metingen gebruiken de propriëtaire native CDNA4-runtime, die niet bij de openbare gewichten zit. Alleen de kwantisatie downloaden levert geen werkende standaard-vLLM-installatie op, en ook niet alles wat nodig is om deze resultaten te reproduceren.
Het nuttigste werk op de GPU houden
Het oorspronkelijke checkpoint bevat circa 269 GiB aan routed experts, 189 GiB aan engram-opzoektabellen en 17 GiB aan overige onderdelen. We comprimeren selectief in plaats van elk gewicht te veranderen.
We houden daarom de meest gebruikte experts op de GPU. De 3.000 vaakst gebruikte experts behouden hun oorspronkelijke 4-bitwaarden. De volgende 2.812 gebruiken ons 3-bitformaat, met inclusief schalen circa 3,3 bits per gewicht. Nog eens 9.548 experts blijven in hun oorspronkelijke 4-bitformaat in hostgeheugen. Een groep van 1.024 GPU-slots volgt de experts die de lopende verzoeken gebruiken.
Tijdens tekstgeneratie berekenen de host-CPU's de minder gebruikte experts ter plaatse. Alleen hun invoer en uitvoer gaan over PCIe, niet telkens de volledige expertgewichten. Voor lange prompts streamt de runtime deze experts wel naar de GPU: de grotere batch maakt dat dan zinvol. De engram-tabellen blijven in hostgeheugen, gecomprimeerd in een 4-bitformaat per rij.
De geteste machine heeft twee AMD EPYC 9654-CPU's, met de MI350P via PCIe Gen5 x16. Het uitgebrachte hostprofiel B gebruikt ongeveer 287,5 GB voor het model, inclusief hostexperts, gecomprimeerde engram-tabellen en vastgezette buffers. Dat is een modelallocatie, geen specificatie voor het minimale totale systeemgeheugen. Het besturingssysteem, laden en andere processen hebben ook ruimte nodig.
Afzonderlijke enginediagnostiek wijst bij zwaardere decodelast op CPU-berekeningen en hostgeheugenbandbreedte als beperkingen. Voldoende RAM alleen garandeert deze snelheid niet. Een andere host of een tweede MI350P hebben we niet gemeten.
Twee profielen voor verschillend werk
Het interactieve profiel reserveert 64 verzoekslots, elk ingesteld op maximaal 70.000 tokens. Het gebruikt de eigen speculatieve drafter van het model voor maximaal twaalf lopende verzoeken. Die stelt twee tokens voor, die het hoofdmodel samen controleert. We hebben voor deze releasemetingen niet vastgelegd welk deel van de voorstellen werd aanvaard.
Het tokenfabriekprofiel schakelt drafting uit en verlaagt de limiet per verzoek naar 12.288 tokens, zodat er 512 slots passen. Het geeft voorrang aan de totale hoeveelheid verwerkt werk boven de snelheid van een individueel antwoord.
Fysieke KV-cachecapaciteit zoals gerapporteerd door de runtime. Slotbudgetten zijn configuratielimieten, geen gemeten gelijktijdige gesprekken van maximale lengte.
| Profiel | Fysieke cache, tokens | Verzoekslots | Limiet per verzoek | Ingesteld slotbudget |
|---|---|---|---|---|
| Interactief | 4.484.095 | 64 | 70.000 | 4.480.000 |
| Tokenfabriek | 6.324.224 | 512 | 12.288 | 6.291.456 |
De KV-cache bewaart de werktoestand voor verwerkte tokens. Geen van beide totalen is een contextvenster voor één verzoek. We hebben ook geen 64 gelijktijdige gesprekken van 70K tokens of 512 gelijktijdige verzoeken van maximale lengte getest. Hun slots reserveren is iets anders dan die belasting meten.
Decodesnelheid zonder promptverwerking
LocalMaxxing meet aanhoudende tekstgeneratie vanuit een lege context, zonder de promptverwerking die een servingtest wel meeneemt.
Totale uitvoertokens/s in LocalMaxxing. Eén MI350P met een ingestelde limiet van 450 W; hoger is beter. Dit zijn geen end-to-end verzoeksnelheden.
| Gelijktijdige verzoeken | 1 | 2 | 4 | 8 | 16 | 32 | 64 |
|---|---|---|---|---|---|---|---|
| Uitvoertokens/s | 77,9 | 112,7 | 166,9 | 241,4 | 377,9 | 518,4 | 709,6 |
Promptverwerking, of prefill, haalt 4.366 invoertokens/s voor een prompt van 8.119 tokens en 4.227 voor een prompt van 63.742 tokens. De gemeten tijden tot het eerste token zijn respectievelijk 1,86 seconden en 15,08 seconden. Dit zijn tests met één prompt, geen latenties bij gelijktijdige aankomsten.
Hoe dit zich verhoudt tot een RTX PRO 6000
We behouden de oorspronkelijke 4-bitwaarden voor de meeste routed experts, in plaats van te vertrekken van een 2-bit Q2_K-checkpoint. Onze eigen 3-bitlaag comprimeert een geselecteerde groep GPU-experts. Dat onderscheid telt even zwaar als het aantal tokens per seconde: een sneller antwoord helpt alleen als het model nog steeds het antwoord geeft dat je nodig hebt.
De openbare deepseek-one-gpu-resultaten bieden een bruikbare referentie op één kaart. Die configuratie gebruikt een RTX PRO 6000 Blackwell met expertberekeningen op de CPU en een Q2_K-checkpoint. Hieronder staan afzonderlijk gerapporteerde decodemetingen, geen GPU-benchmark onder gelijke omstandigheden:
| Paiton / 1 × MI350P | deepseek-one-gpu / 1 × RTX PRO 6000 | |
|---|---|---|
| GPU-geheugen | 144 GB | 96 GB |
| Expertgewichten | Oorspronkelijke FP4 voor de meeste experts; eigen 3-bitlaag op GPU | Q2_K-checkpoint, door de auteurs omschreven als 2-bit |
| Eén verzoek, uitvoertokens/s | 77,9 | 63,11 |
| Vier verzoeken, totale uitvoertokens/s | 166,9 | 127,58 |
| Acht verzoeken, totale uitvoertokens/s | 241,4 | 152,53 |
Paiton rapporteert hier hogere decodesnelheden en behoudt tegelijk meer precisie in de expertgewichten. De metingen verschillen: wij gebruiken LocalMaxxing met lege context en meetvakken van dertig seconden. De RTX-resultaten middelen drie vensters van vijftien seconden, na het lezen van ongeveer 16K tokens per verzoek. Ook de CPU's, geheugencapaciteit en checkpoints verschillen. De RTX-metingen met één en vier verzoeken gebruiken een EPYC 9575F; die met acht een EPYC 9655. Wij gebruiken twee EPYC 9654's. Deze cijfers isoleren de GPU niet en meten geen gecontroleerde Paiton-versnelling.
Waarom we meer precisie behouden
Onze servingchecks meten circa 0,031 chat-KL, 0,042–0,044 lange-context-KL en 94–95% overeenkomst voor het volgende token ten opzichte van het oorspronkelijke model. De terugzoektests vinden ook elke geteste wachtzin. De steekproefgroottes en beperkingen staan in de sectie over nauwkeurigheid hieronder.
Het kwaliteitsverslag van het RTX-project meet daarentegen taken, waaronder GSM8K en HumanEval, tegenover de DeepSeek-API. Wij hebben diezelfde tests niet uitgevoerd voor deze release en het RTX-project publiceert geen overeenkomstige KL-meting. Onze selectieve kwantisatie behoudt meer oorspronkelijke precisie in de expertgewichten. Een cijfermatige claim dat ze nauwkeuriger is dan Q2_K vraagt nog een gezamenlijke evaluatie.
Meer resultaten op één machine
Dezelfde modelfamilie draait ook op kleinere NVIDIA-kaarten en Apple Silicon. Deze verslagen maken andere afwegingen tussen expertprecisie, GPU-geheugen, systeemgeheugen en SSD-toegang. Hieronder staan metingen van de auteurs, geen herhalingen op onze testmachine.
| Configuratie en bron | Gewichten en geheugen | Gerapporteerde uitvoer bij één verzoek | Testcontext |
|---|---|---|---|
| Paiton / 1 × MI350P | Meeste experts behouden oorspronkelijke FP4; geselecteerde GPU-experts gebruiken 3-bit. 144 GB GPU-geheugen, circa 290 GB hostmodeldata | 77,9 tok/s | LocalMaxxing, lege startcontext, meetvakken van dertig seconden; twee EPYC 9654-CPU's berekenen minder gebruikte experts |
| RTX 5090 / Project Maya | Maya-S-experts in 2–3 bit; 32 GB VRAM, 128 GB RAM, NVMe-offload | 26,3–26,7 tok/s | Update van de auteur op 29 oktober, Maya 1.1.27, drafting uit; Ryzen 9 9950X3D |
| RTX 3090 / dsv41-flash-offload | EXL3-experts in 3-bit; 24 GB VRAM, gemeten host met 503 GiB DDR4; Engram op NVMe | 19,3 tok/s | Gepubliceerde D141-standaard; EPYC 7443P. Rapporteert ook 26,6 totale tok/s bij vier streams |
| Mac Studio M3 Ultra / Rapid-MLX | Routed experts in gemengde 2–3 bit; 256 GB gedeeld geheugen; 4-bit-Engram op SSD | 34,3–42,7 tok/s | Standaard draftingdiepte twee, prompts van circa 0,7–1K tokens en 256 uitvoertokens; tot 49,0 tok/s voor code bij draftingdiepte vier |
Onze aanpak laat meer oorspronkelijke expertgewichten intact, in plaats van alle routed experts naar 2–3 bit te kwantiseren. De configuraties met kleinere kaarten gebruiken veel minder GPU-geheugen. De RTX 5090-host heeft ook aanzienlijk minder RAM. Hun lagere snelheden bewijzen geen geïsoleerd nadeel van de GPU of software.
Kwaliteitscijfers vragen dezelfde zorg. Rapid-MLX rapporteert 0,260 KL en 85,1% top-1-overeenkomst op een aparte testset van 19.456 posities, met KL over de volledige woordenschat. Onze circa 0,031 chat-KL en 95% overeenkomst komen van 1.767 posities met top-64-bucket-KL. Die verschillende tests bewijzen geen nauwkeurigheidsverhouding. De 0,0068 KL van het RTX 3090-project vergelijkt een uitvoeringspad met hetzelfde gekwantiseerde pakket, niet het kwantisatieverlies tegenover het oorspronkelijke model.
Wat verandert er met meer GPU's?
Meer kaarten kunnen aanzienlijk hogere snelheden opleveren, maar passen bij een ander hardwarebudget. Dit zijn resultaten van de volledige configuratie, niet per GPU.
| Configuratie en bron | Modelplaatsing | Afzonderlijk gerapporteerd resultaat |
|---|---|---|
| 2 × RTX PRO 6000 / Diffbot | Samen 192 GB VRAM; gekalibreerde EXL3-experts in 3-bit, een derde in vastgezet hostgeheugen | Agentic replay met één stream: 224,1 tok/s met expertberekeningen op GPU, of 261,8 met de optionele CPU-runtime |
| 4 × B200 / Lambda | Officieel checkpoint, vLLM TP4, vijf speculatieve tokens | Circa 8K invoer / 1K uitvoer: 374,8 totale uitvoertokens/s bij één verzoek; 3.713,9 bij 64 en 4.858,7 bij 256 |
Doordat Diffbot experts in hostgeheugen houdt, is de tweekaartsmeting geen volledig VRAM-residente installatie. Lambda's cijfers omvatten promptverwerking over 512 prompts per gelijktijdigheidsniveau, anders dan onze LocalMaxxing-decodematrix. Geen van beide is een vergelijking onder gelijke omstandigheden met onze run op één kaart.
Voor een latentiegevoelige dienst kunnen de extra GPU's de moeite waard zijn. Ons resultaat beantwoordt een andere vraag: wat kan één MI350P met een krachtige CPU-host, terwijl het grootste deel van de oorspronkelijke expertprecisie behouden blijft?
Wat als verzoeken tegelijk binnenkomen?
De servingtest omvat zowel invoerverwerking als tekstgeneratie. Hier betekent 1K 1.024 tokens. Verzoeken gebruiken verschillende vensters uit brontekst, greedy generatie en vaste uitvoerlengtes, waarbij EOS wordt genegeerd. Het zijn gelijktijdige synthetische verzoeken, geen meting met evenveel mensen die een assistent gebruiken.
1K invoer / 1K uitvoer. Totale doorvoer en mediane decode per verzoek meten verschillende zaken. De tijd tot het eerste token omvat promptverwerking.
| Profiel | Verzoeken | Totale uitvoer, tok/s | Decode per verzoek, tok/s | Eerste token, mediaan / steekproef-p99 |
|---|---|---|---|---|
| Interactief | 1 | 90,7 | 95,4 | 0,69 / 0,77 s |
| Interactief | 4 | 154,3 | 42,4 | 0,80 / 2,87 s |
| Interactief | 16 | 203,8 | 14,4 | 8,91 / 11,42 s |
| Interactief | 64 | 297,2 | 5,2 | 28,25 / 44,64 s |
| Tokenfabriek | 256 | 542,8 | 2,6 | 91,56 / 178,51 s |
| Tokenfabriek | 384 | 620,8 | 2,1 | 131,76 / 249,57 s |
| Tokenfabriek | 512 | 682,5 | 1,7 | 167,90 / 331,24 s |
Eén verzoek begint binnen een seconde te antwoorden. Bij zestien verzoeken duurt dat mediaan bijna negen seconden; bij 64 is het 28 seconden. De kaart produceert meer in totaal, maar elk antwoord wordt trager. Bij 512 fabrieksverzoeken nadert de wachttijd drie minuten.
Decode per verzoek wordt afgeleid van de mediane tijd per uitvoertoken na het eerste token. Het is niet de totale doorvoer gedeeld door het aantal verzoeken. Steekproef-p99 beschrijft deze vastgelegde verzoeken, geen populatiepercentiel of productiegarantie. Wisselende aankomsten, promptlengtes, toolaanroepen en scheduling vragen om een eigen capaciteitstest.
Lange invoer belast serving zwaarder
Bij 8K invoer en een antwoord van 1K gaat meer tijd naar promptverwerking. Bij 64 verzoeken bereikt de interactieve mediane wachttijd 70,45 seconden. Bij 512 fabrieksverzoeken is dat 586,39 seconden, bijna 9,8 minuten, met een steekproef-p99 van ongeveer 19,9 minuten.
8K invoer / 1K uitvoer. De langere prompt verhoogt de tijd tot het eerste token sterk, vooral in het batchprofiel.
| Profiel | Verzoeken | Totale uitvoer, tok/s | Decode per verzoek, tok/s | Mediaan eerste token |
|---|---|---|---|---|
| Interactief | 1 | 79,5 | 95,2 | 1,83 s |
| Interactief | 4 | 129,8 | 39,9 | 3,87 s |
| Interactief | 16 | 151,1 | 12,1 | 17,09 s |
| Interactief | 64 | 201,6 | 4,0 | 70,45 s |
| Tokenfabriek | 256 | 299,1 | 1,8 | 285,42 s |
| Tokenfabriek | 384 | 317,8 | 1,3 | 434,14 s |
| Tokenfabriek | 512 | 328,9 | 1,1 | 586,39 s |
Een prefillmeting met één prompt voorspelt niet de latentie voor een wachtrij met lange documenten. Dit batchprofiel past niet bij iemand die onmiddellijk antwoord verwacht.
Lange antwoorden verhogen de totale uitvoer
Bij 1K invoer en 8K uitvoer wordt de promptverwerking over veel meer gegenereerde tekst verdeeld. De fabriek haalt 1.107,6 tokens/s bij 512 verzoeken, tegenover 682,5 voor korte antwoorden. De individuele generatie blijft steken op 2,3 tokens/s, na een mediane wachttijd van 180,84 seconden tot het eerste token.
1K invoer / 8K uitvoer. Meer totale uitvoer maakt een individueel batchverzoek nog niet interactief.
| Profiel | Verzoeken | Totale uitvoer, tok/s | Decode per verzoek, tok/s | Mediaan eerste token |
|---|---|---|---|---|
| Interactief | 1 | 109,0 | 120,0 | 0,72 s |
| Interactief | 4 | 199,3 | 52,3 | 2,99 s |
| Interactief | 16 | 243,6 | 15,4 | 11,02 s |
| Interactief | 64 | 370,5 | 5,9 | 29,09 s |
| Tokenfabriek | 256 | 813,2 | 3,3 | 92,90 s |
| Tokenfabriek | 384 | 953,4 | 2,6 | 138,96 s |
| Tokenfabriek | 512 | 1.107,6 | 2,3 | 180,84 s |
Offline samenvattingen, evaluaties en datageneratie kunnen die afweging verdragen. Een interactieve codeerassistent doorgaans niet. Het bruikbare werkpunt hangt af van de uitvoerlengte en aanvaardbare wachttijd, niet alleen van het hoogste doorvoercijfer.
Vermogen: de limiet is niet het verbruik
De instelling van 450 W is een GPU-vermogenslimiet, geen bewering dat de GPU voortdurend 450 W verbruikt. Bij 512 fabrieksverzoeken is het gemiddelde GPU-vermogen 212,5 W voor 1K / 1K en 214,7 W voor 1K / 8K. Gecombineerd met de uitvoer komt dat neer op ongeveer 0,086 en 0,054 Wh per 1.000 uitvoertokens.
De fabrieksmeting met lange invoer verbruikt meer, gemiddeld 273,4 W bij 512 verzoeken, terwijl er minder uitvoer is. Interactieve 1K / 1K-metingen komen uit op gemiddeld 251,8 W bij één verzoek en 207,6 W bij 64. Meer batching kan de GPU-energie per token dus verbeteren terwijl individuele antwoorden vertragen.
Deze cijfers omvatten alleen de energie van de GPU-kaart. Ze sluiten de twee CPU's die offloaded experts berekenen, systeemgeheugen, opslag, voedingsverliezen en koeling uit. Zonder metingen van het hele systeem tonen ze geen totale energiekosten of financieel rendement aan.
Hoe dicht blijven de voorspellingen bij het origineel?
We vergelijken teacher-forced voorspellingen van het volgende token met het oorspronkelijke model op twee MI355X-GPU's. KL-divergentie meet het verschil tussen kansverdelingen; nul betekent identiek. De diagnostiek groepeert de 64 waarschijnlijkste referentietokens en de resterende kansmassa. Top-1-overeenkomst kijkt of beide configuraties hetzelfde waarschijnlijkste volgende token kiezen.
Voorspellingschecks tijdens serving met acht gelijktijdige verzoeken, behalve de apart aangeduide chatcheck met 512. Dit zijn geen accuratessecijfers voor antwoorden op taken.
| Profiel / check | Chat-KL | Chat-top-1 | Lange-context-KL | Lange-context-top-1 |
|---|---|---|---|---|
| Interactief, c8 | 0,0307 | 95,0% | 0,0438 | 94,2% |
| Tokenfabriek, c8 | 0,0311 | 94,5% | 0,0418 | 94,2% |
| Tokenfabriek, c512 | 0,0306 | 94,5% | Niet gemeten | Niet gemeten |
Chat omvat 1.767 beoordeelde posities. De lange-contextcheck omvat 1.000 posities uit veertig gesprekken. De profielnamen beschrijven serverconfiguraties, geen bewijs dat elke kwaliteitstest met 64 of 512 verzoeken liep. Een tokenovereenkomst van 95% betekent niet dat 95% van de antwoorden correct is. We hebben voor deze release geen taakbenchmarks uitgevoerd voor wiskunde, programmeren, kennis, meertaligheid of toolgebruik.
Herhaalde runs verschillen ook licht door de rekenwijze en discrete expertrouting. De gepubliceerde interactieve ruischecks geven 0,0039 KL voor chat en 0,0033 voor lange context, maar gebruikten een oudere prefillchunk van 16K in plaats van de uitgebrachte 8K. Fabrieksherhalingen geven 0,0006 en 0,0086. Ze helpen de diagnostiek te begrijpen, maar zijn niet voor elke rij een passende controle van de releasebuild.
Het lange-contextresultaat heeft een belangrijke beperking. Onze interne grens is 0,045 KL. De gemeten servingchecks op 1.000 posities blijven daaronder. Op een grotere set van 171.200 posities vermeldt de modelkaart 0,0444 uit een rekenemulator, met een projectie van ongeveer 0,0456 tijdens serving, net boven de grens. Dat is een projectie, geen meting van de draaiende server over de volledige set. Ruwe emulatorresultaten voor die hele set ontbreken in de openbare bewijsbestanden.
Terugzoektests vonden alle twaalf verborgen wachtzinnen in interactieve prompts tot 68.160 tokens en alle zes fabriekswachtzinnen tot 11.033 tokens. Dat ondersteunt deze specifieke terugzoektest, niet algemene nauwkeurigheid bij lange documenten.
Wat gebeurde er met standaardengines?
Onze gepubliceerde samenvatting van standaardconfiguraties betreft het oorspronkelijke checkpoint op dezelfde MI350P-host. vLLM 0.33.0 beantwoordt uiteindelijk kleine prompts via zijn referentie-MoE-pad aan ongeveer 0,2 tokens/s, na 35 tot 47 minuten laden. Een prompt van 1.024 tokens loopt vervolgens vast door GPU-geheugentekort. De geteste snelle MoE-paden passen evenmin. SGLang 0.5.23 en de geteste ROCm-preview lopen tijdens het laden tegen geheugentekort aan.
Deze pogingen leverden geen bruikbare standaard-servingbaseline voor deze kaart op. Ze bewijzen niet dat elke mogelijke configuratie faalt. Het openbare bewijsmateriaal voor deze pogingen bevat een samenvatting, OOM-fragmenten en een klein verzoekbestand, geen volledige commando's, complete containerdigests en geheugentraces voor elke poging.
Bekijk de metingen
De openbare gewichten en modelkaart zijn vastgezet op revisie 2dd8058e. De afgeleide bestanden gebruiken de MIT-licentie, net als het oorspronkelijke model. Dit is een patch van 135,8 GiB, geen zelfstandig model: de runtime heeft ook het oorspronkelijke checkpoint van 475 GiB nodig. Standaardengines kunnen ons 3-bitexpertformaat en onze plaatsingskaart niet rechtstreeks laden.
De proof-map bevat LocalMaxxing-matrices, servingrecords per verzoek, vermogenslogs, kwaliteitschecks en de oorspronkelijke terminalopname. We hebben 68 bewijsbestanden gecontroleerd aan de hand van het SHA-256-manifest. Dat bevestigt bestandsintegriteit, geen onafhankelijke validatie van het experiment. De openbare logs maken inspectie mogelijk, maar de propriëtaire runtime en ontbrekende evaluatiebestanden verhinderen volledige onafhankelijke reproductie.
Ongewijzigde benchmarkscreenshot. De oorspronkelijke geanimeerde terminalopname toont een afzonderlijke live run, niet de geselecteerde hoofdmatrix.
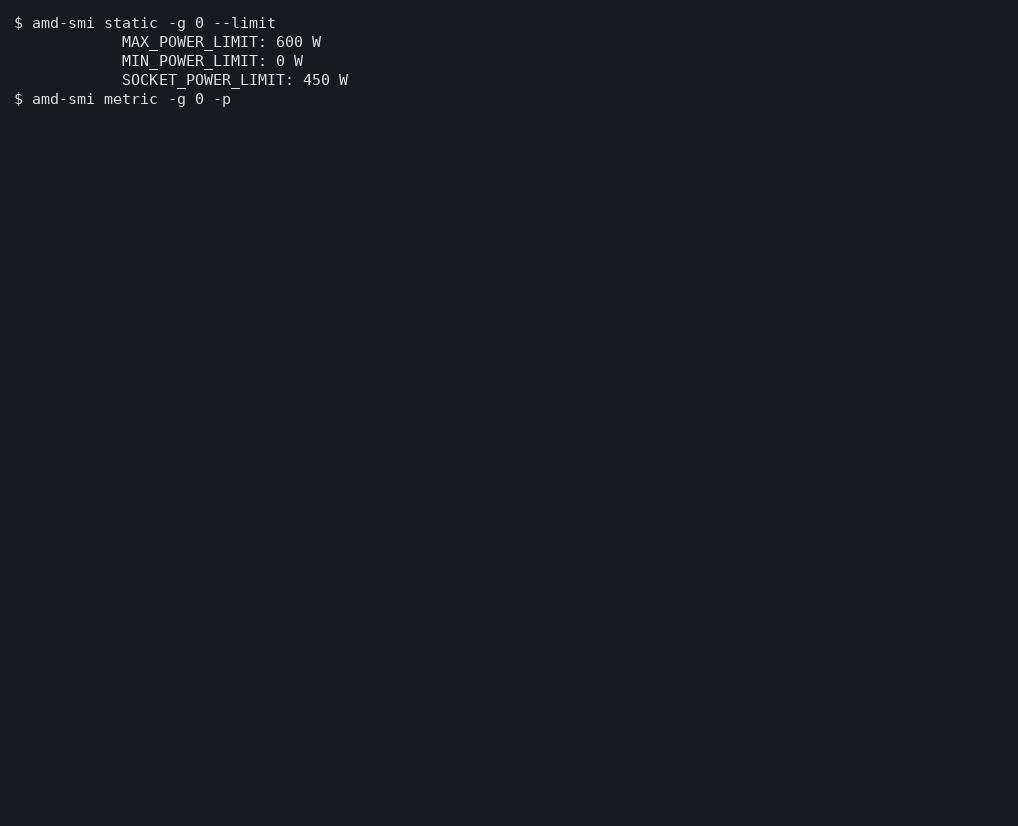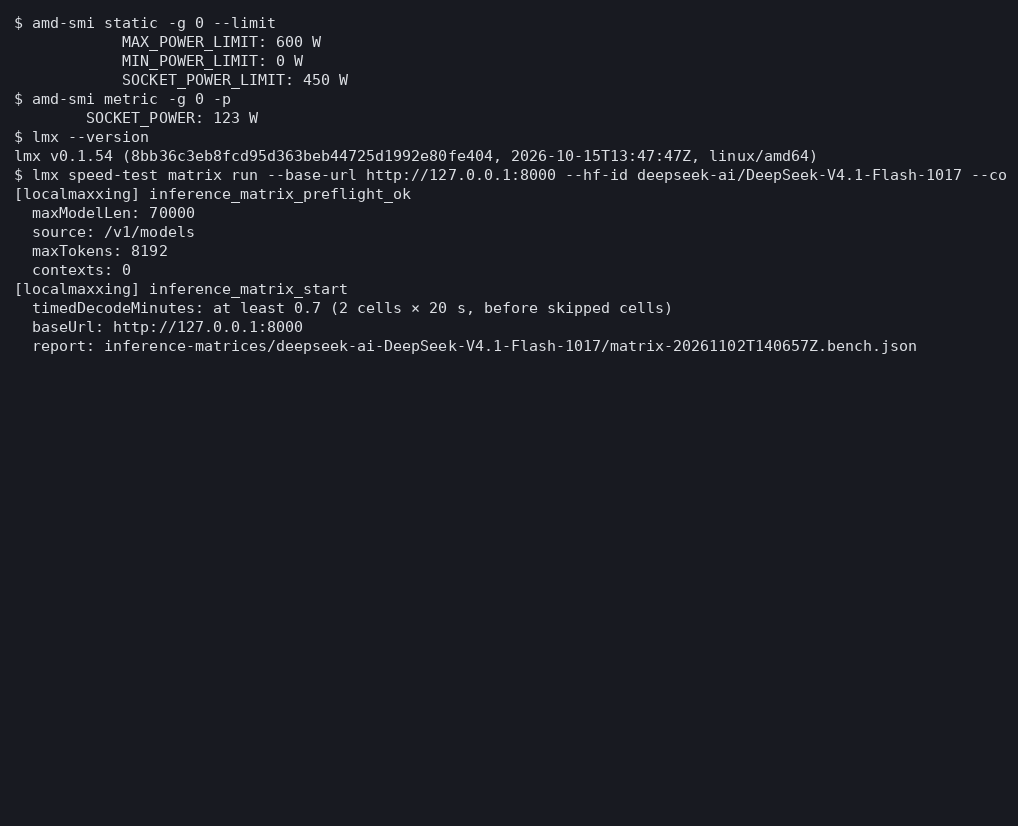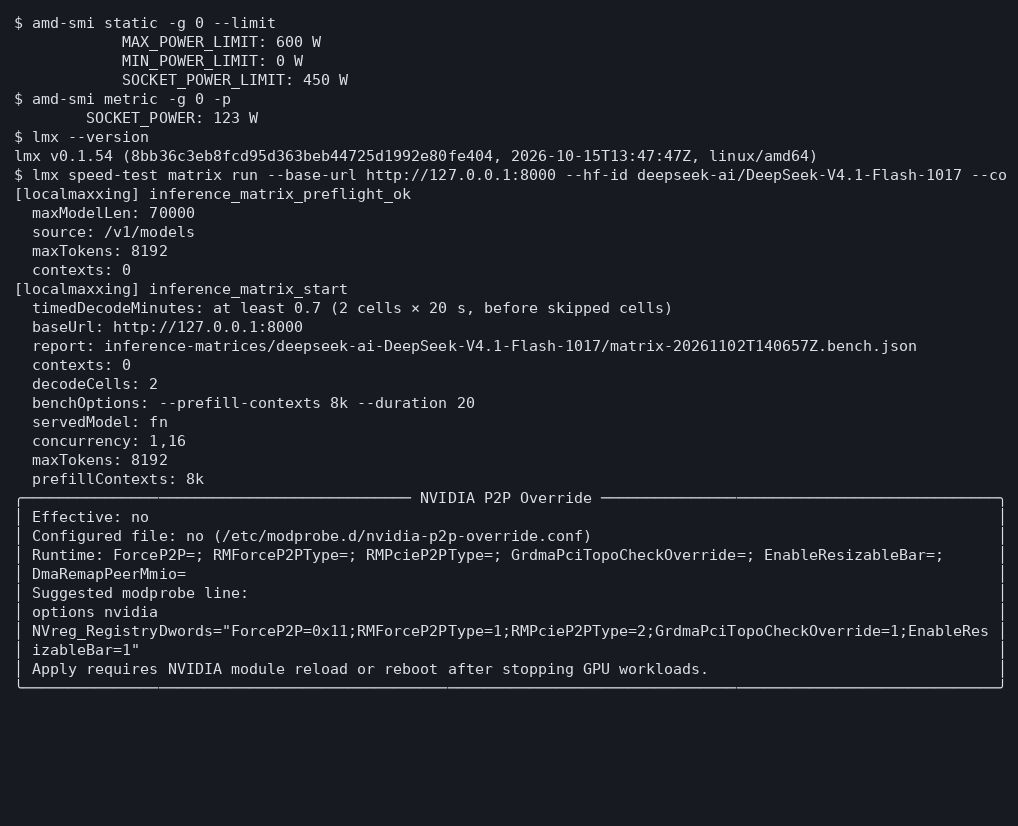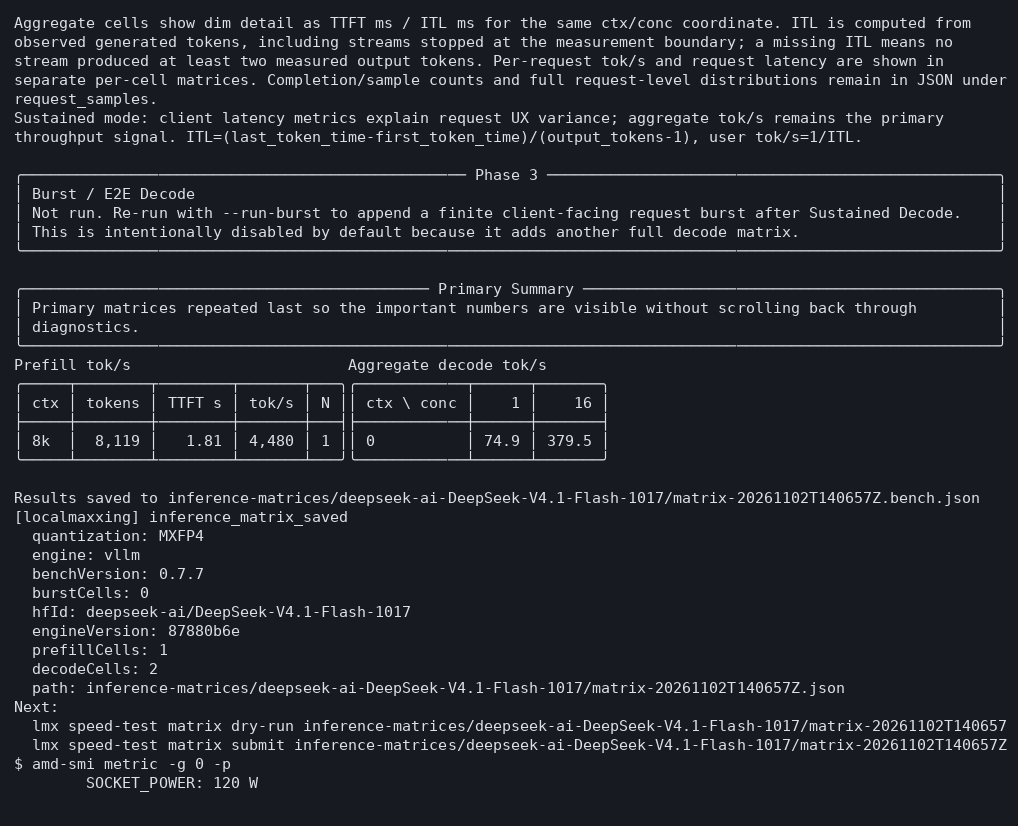
LocalMaxxing gebruikt lmx 0.1.54 en llm-inference-bench 0.7.7, met decodevakken van dertig seconden. We draaiden drie volledige matrices op de opgewarmde server en selecteerden de volledige run met de mediane single-request-decode. De servingtest gebruikt een aparte streamingclient en twee opwarmrondes. Grafiekdata en bronpaden houden de tests gescheiden.
Ons vorige MI350P-artikel behandelt Qwen3.8 Flash Next met veel minder hostberekeningen. Het Radeon-werk op RDNA4 onderzoekt een ander model en geheugenbudget. Beide volgen dezelfde Paiton-aanpak: opslagformaat en uitvoering samen kiezen, en daarna het resultaat op de doelhardware meten.
Voor DeepSeek maakt deze release een groot model bruikbaar met één MI350P en een stevige CPU-host. Ze vervangt niet de latentie van een volledig op GPU's draaiende installatie. De volgende nuttige checks zijn energieverbruik van de hele host, taakkwaliteit en een gemeten configuratie met twee kaarten.
Lees meer over Paiton of bekijk het gelinkte bewijsmateriaal voordat je een servingprofiel kiest.
Cover: AI-gegenereerde redactionele illustratie, geen productfoto of benchmarkopname.
Een tokenfabriek bouwen op AMD?
Plan je batchinferentie of draai je al modellen op AMD-hardware? We helpen je graag doorvoer, latentie en geheugengrenzen met jouw werklast in kaart te brengen.