De Radeon AI PRO R9700 doet al heel wat lokaal AI-werk met Paiton. Qwen3.8 27B beantwoordt programmeervragen, FLUX.2 klein maakt een afbeelding in ongeveer een seconde, Qwen-Image 2.1 en MiniMax-H3-Image genereren en bewerken beelden, en Idol zet één afbeelding in ongeveer 16 seconden om in een 3D-object.
Video ontbrak nog. Onze eerdere videopakketten draaiden binnen ComfyUI en PyTorch, waar Paiton maar een deel van het werk kon versnellen: van geen winst bij Wan2.2 tot ongeveer 15% bij MiniMax H3. Deze week brachten we twee videomodellen uit die Paitons eigen kernels gebruiken, van de prompt tot en met de video- en audiodecoders. Beide maken het geluid samen met het beeld:
| Model | Wat het doet | Clip van 5 seconden op één R9700 |
|---|---|---|
| LTX-2.5, Lightricks, 22B | Tekst of een eerste frame naar video met audio, 704p en 1080p | 18,1 s op 1280 x 704; 48,8 s op 1920 x 1088 |
| MiniMax H3 v1.2 | Video met stereogeluid uit een prompt en maximaal negen referentiebeelden | 30,4 s met één referentie; 44,3 s met negen, op 864 x 480 |
Beide blijven binnen de 32 GB VRAM van de kaart: we maten pieken van 27,4 GiB voor LTX-2.5 op 1080p en 26,8 GiB voor MiniMax H3. Dat is het GPU-geheugen, niet het geheugengebruik van het hele systeem. Beide laden ook lagen van de tekstencoder vanuit het systeemgeheugen. De begin- en eindpunten van de tijdmeting verschillen per model; die lichten we hieronder toe.
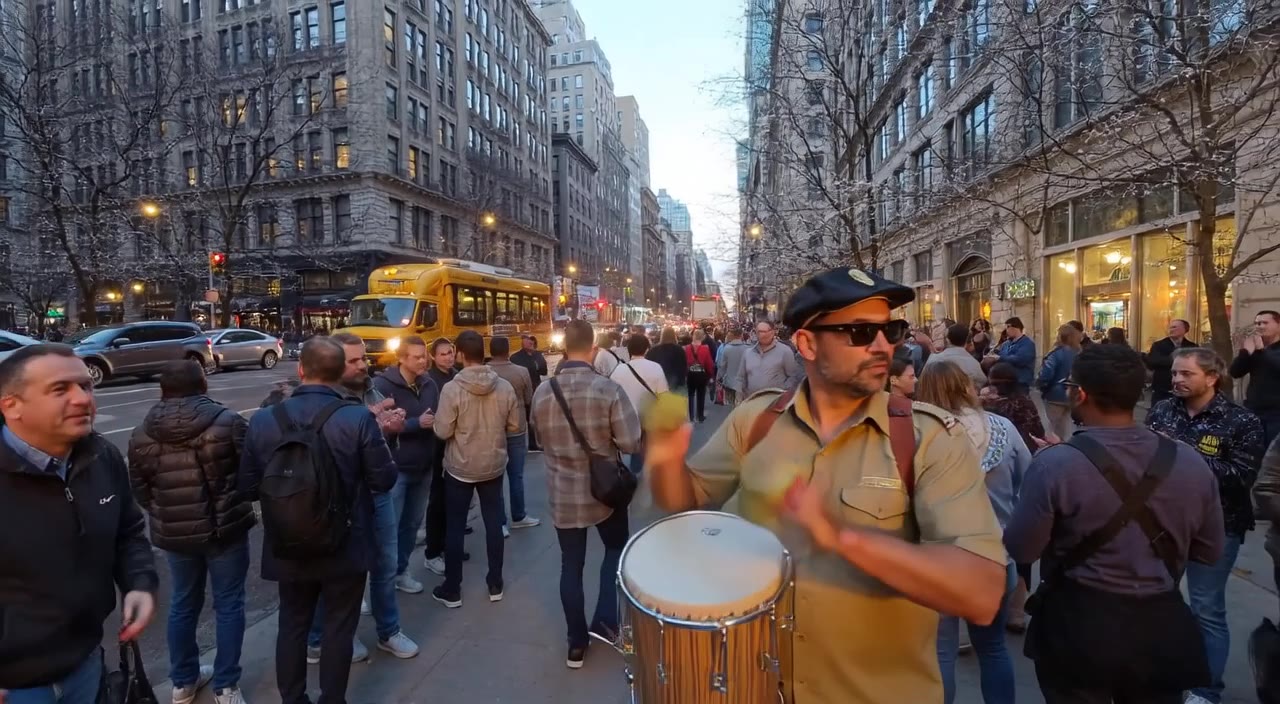
De omslag is een onbewerkt frame uit de AI-gegenereerde LTX-2.5-clip hieronder.
In dit artikel
- Bekijk de LTX-2.5-clip
- LTX-2.5: resultaten en kwaliteit
- MiniMax H3 v1.2: resultaten en kwaliteit
- Zelf proberen op je R9700
- Licenties
Bekijk de clip
AI-gegenereerde video en audio van LTX-2.5 op één R9700, onbewerkt overgenomen uit het aangeleverde voorbeeld. Prompt: "A street drummer plays a fast rhythm on a city sidewalk at dusk while the crowd claps and cheers". 1280 x 704, 121 frames bij 24 fps, ongeveer 5 seconden video. De gemeten warme aanvraag duurt 18,1 seconden. Druk op afspelen om het geluid te horen.
LTX-2.5: een clip van 5 seconden in 18 seconden
LTX-2.5 is het audio- en videomodel van Lightricks met 22 miljard parameters. We draaien de gedistilleerde pipeline in twee fasen: 8 stappen op halve resolutie, een 2x vergroting van de latent, dan 3 stappen op volledige resolutie, gevolgd door de video- en audiodecoders. De standaardpipeline kan de 16-bits gewichten niet in één R9700 kwijt en moet ze daarom naar de CPU offloaden. Een 1080p-clip duurt dan zeven minuten. Paitons native GPU-pipeline brengt dat terug tot 48,8 seconden, terwijl de lagen van de tekstencoder die niet in VRAM passen vanuit het systeemgeheugen worden geladen.
121 frames met audio, één R9700 op 300 W. Paiton: warme HTTP-aanvraag tot afgewerkte MP4, gemeten op de server, mediaan van drie runs. Standaard: warme BF16-pipeline met CPU-offload. Paiton gebruikt FP8, dus we vergelijken uitvoeringsconfiguraties, niet dezelfde precisie.
| Aanvraag, 121 frames, ongeveer 5 s bij 24 fps | Paiton | Standaard LTX-2.5, BF16 | Versnelling |
|---|---|---|---|
| Tekst naar video, 1280 x 704 | 18,1 s | 128,6 s | 7,1x |
| Afbeelding naar video, 1280 x 704 | 21,1 s | Niet gemeten | Niet gemeten |
| Tekst naar video, 1920 x 1088 | 48,8 s | 420,5 s | 8,6x |
| Afbeelding naar video, 1920 x 1088 | 51,9 s | Niet gemeten | Niet gemeten |
Paitons tijden worden op de server gemeten van de HTTP-aanvraag tot de afgewerkte MP4, als mediaan van drie warme runs en met de kaart op haar limiet van 300 W. Daar zitten de tekstencoder, beide samplingfasen, de vergroting, beide decoders en de H.264- en AAC-encoding in. Opstarten en het downloaden van gewichten tellen niet mee.
De meeste snelheidswinst komt van de transformer in FP8, voor zowel gewichten als activaties, en attention in INT8 en FP8, op kernels voor de RDNA4-chip van de R9700. De timestep-conditioning wordt vooraf één keer berekend voor de negen vaste ruisniveaus van het gedistilleerde schema. De stappen draaien als HIP graphs. De tekstencoder met 12 miljard parameters laadt de lagen die niet op de kaart passen vanuit het systeemgeheugen.
En de kwaliteit? Een FP8-versie van deze sampler met 11 stappen maakt niet exact dezelfde video als het 16-bits model: kleine numerieke verschillen kunnen tijdens de stappen uitgroeien tot een ander cameraverloop of een andere indeling van de scène. Dat gebeurt ook met Lightricks' eigen FP8-modus. We vergeleken beide FP8-versies met een 16-bits run die van dezelfde ruis vertrok. Op 704p ligt Paiton even dicht bij die run als de standaard FP8-modus: 25,7 dB tegenover 25,3 dB PSNR. Op 1080p is de afstand gemiddeld 1,1 dB groter over vijf prompts, met twee lagere scores en drie gelijke of hogere. We bekeken de frames naast elkaar en zagen in die gevallen geen blokvorming, banding of ruis. Dit is een beperkte kwaliteitscontrole, geen belofte van identieke video's.
De LTX-2.5-handleiding bevat alle cijfers en de beperkingen van deze eerste versie: twee gemeten resoluties, geen staande formaten en een cliplengte die je zelf moet opgeven.
AI-gegenereerd voorbeeld van afbeelding naar video op 1920 x 1088. De gemeten aanvraag maakt 121 frames met audio in 51,9 s.
MiniMax H3 v1.2: video met je eigen referentiebeelden
MiniMax H3 maakt een clip uit een prompt en referenties: maximaal negen afbeeldingen, of een video waarvan het de
soundtrack als audioreferentie gebruikt. Met een prompt als "the red panda from <Picture 1> walks through a sunlit
forest" stuur je de clip met je eigen afbeelding. De audio is 32 kHz stereo.
Ons eerdere v1.1.0-pakket gebruikte ComfyUI, waarbij Paiton de sampler verving. v1.2 vervangt ook de andere modelonderdelen: de tekstencoder met 32 miljard parameters, de referentie-encoder, de transformer en de video- en audiodecoders draaien nu op Paitons HIP-kernels, zonder PyTorch, Triton of ComfyUI in de container. Op 864 x 480 groeit de winst tegenover de standaardengine met het aantal referenties:
124 frames, Turbo4, één R9700 op 300 W. Standaard: gemiddelde van twee warme runs, van het laden van referenties tot de geschreven MP4. Paiton v1.2: gepubliceerde M2-run, van voorbereide invoer tot geschreven MP4, zonder invoervoorbereiding op de CPU of het laden van gewichten. Standaard gebruikt W4A8; v1.2 gebruikt FP8.
| Aanvraag, 124 frames, ongeveer 5 s, vierstaps Turbo4 | Standaard | Paiton v1.1.0 | Paiton v1.2 | v1.2 tegenover standaard |
|---|---|---|---|---|
| 864 x 480, 1 referentiebeeld | 67,4 s | 50,6 s | 30,4 s | 2,2x |
| 864 x 480, 3 referentiebeelden | 91,2 s | 85,3 s | 33,4 s | 2,7x |
| 864 x 480, 9 referentiebeelden | 167,5 s | 178,7 s | 44,3 s | 3,8x |
| 1344 x 768, 9 referentiebeelden | 278,7 s | 258,4 s | 114,1 s | 2,4x |
| 864 x 480, 1 referentievideo met soundtrack | Niet gemeten | Niet gemeten | 203,8 s | Niet gemeten |
De standaardvergelijking die voor dit artikel werd aangeleverd gebruikt de MiniMax H3 reference-to-video-workflow in ComfyUI met zijn eigen engine, op dezelfde kaart, met dezelfde prompts, referentiebeelden, resoluties en seed als v1.2. Die draait het W4A8-checkpoint uit ons v1.1.0-pakket, terwijl v1.2 FP8-gewichten gebruikt. De kolom v1.1.0 komt uit de release van oktober, met andere prompts en beelden van dezelfde afmetingen. Die staat er als historische vergelijking, niet als een gecontroleerde test van drie versies.
De v1.2-metingen beginnen met voorbereide invoer en eindigen met de geschreven MP4. De invoervoorbereiding op de CPU, volgens het rapport minder dan twee seconden, en het laden van gewichten tellen niet mee. Met veel referenties besteedt de standaardengine meer dan de helft van zijn tijd aan het encoderen ervan: 89 van de 168 seconden bij negen referenties in de aangeleverde vergelijking. Daar boekt v1.2 de grootste winst.
De achtstaps Turbo8-preset doet over de eerste rij 51,4 s in v1.2. Het piekgebruik van VRAM blijft in v1.2 onder 27 GiB, tegenover 30,5 tot 30,8 GiB bij v1.1.0.
Voor de kwaliteit vergeleken we vijf gevallen met het 16-bits model op een Instinct MI355X, met dezelfde prompts, referenties, seed en beginruis. Hoe goed de clip bij de prompt past, gemeten met de CLIP-score, ligt binnen de spreiding tussen die gevallen gelijk met het 16-bits model. Bij één of drie referenties blijven de clips dicht bij de 16-bits versies. Bij negen referenties zijn de onderwerpen en de scène aanwezig, maar kunnen ze anders in beeld staan.
Het benchmarkrapport bevat de v1.2-scores per geval en de beperkingen: tot ongeveer 9,4 seconden op 768p met negen referenties, geen losse audioreferenties en Base50 blijft op v1.1.0.
Een eerder MiniMax H3-voorbeeld, geen uitvoer van de v1.2-benchmark. De volledige clip van 15 seconden staat in ons oorspronkelijke videoartikel.
Zelf proberen
Beide modellen starten met één commando vanuit een checkout van de paiton-vllm-plugin-repository. Je hebt één R9700, Linux, Docker en een werkende ROCm-kerneldriver nodig. De eerste start downloadt de gewichten, ongeveer 38 GB voor LTX-2.5 of 51 GB voor MiniMax H3 Turbo4, en controleert elk bestand aan de hand van zijn SHA-256.
Reken naast VRAM ook op systeemgeheugen. LTX-2.5 houdt ongeveer 14,1 GB aan tekstencodergewichten vast in het hostgeheugen; de snelste tekstencodermodus van MiniMax H3 heeft ongeveer 41 GB vrij hostgeheugen nodig. MiniMax H3 v1.2 is niet getest op een host met minder dan 64 GB RAM. De handleidingen beschrijven de volledige RAM- en schijfvereisten.
Accepteer voor LTX-2.5 eerst de licentie op de gewichtenpagina. Vervang de tokenplaceholder hieronder door een Hugging Face-leestoken van datzelfde account:
git clone --depth 1 https://github.com/Eliovp-BV/paiton-vllm-plugin.git
cd paiton-vllm-plugin
export HF_TOKEN='hf_your_read_token'
./models/LTX-2.5/launch.sh
# In een tweede terminal, vanuit dezelfde checkout, zodra READY verschijnt:
./models/LTX-2.5/run.sh generate "A street drummer plays a fast rhythm on a city sidewalk at dusk while the crowd claps and cheers" --out drummer.mp4
Beide servers gebruiken standaard poort 30000. Stop LTX-2.5 voordat je MiniMax H3 op die poort probeert:
./models/LTX-2.5/run.sh stop
Voor MiniMax H3 v1.2, vanuit dezelfde checkout, met een referentiebeeld opgeslagen als panda.png:
PAITON_DETACH=1 ./models/MiniMax-H3/native/launch.sh http
docker logs -f paiton-minimax-h3-v12
# Wacht op READY en voer de aanvraag dan uit in een andere terminal:
curl --fail-with-body -o panda.mp4 -F image=@panda.png \
  -F prompt='The red panda from <Picture 1> walks through a sunlit forest. Audio: birds and a stream.' \
  http://127.0.0.1:30000/v1/videos/generations
Beide hebben een HTTP-API. H3 bevat ook een ComfyUI-node die aanvragen naar de native server stuurt. Deze videoscripts zijn modelspecifiek en staan los van de presets voor taalmodellen.
Licenties
De repositorycode valt onder Apache-2.0, maar dat vervangt de modellicenties of de voorwaarden voor afgeleide runtimes niet. LTX-2.5 gebruikt de LTX-2.x Community License. Bedrijven met een jaaromzet van minstens 10 miljoen Amerikaanse dollar hebben een betaalde licentie van Lightricks nodig voor gebruik buiten niet-commercieel testen en onderzoek. Gepubliceerde gegenereerde media moeten als AI-gegenereerd herkenbaar zijn.
MiniMax H3 gebruikt zijn eigen Community License. De standaardlicentie sluit de EU, het VK, Zuid-Korea en de VS uit, ook voor het gebruiken en tonen van uitvoer. Organisaties met een jaaromzet boven 20 miljoen Amerikaanse dollar hebben schriftelijke toestemming nodig. Controleer de volledige voorwaarden en eventuele aparte toestemming voor jouw gebruik. Een downloadbare runtime geeft geen onbeperkte toestemming om het model of zijn uitvoer te gebruiken.