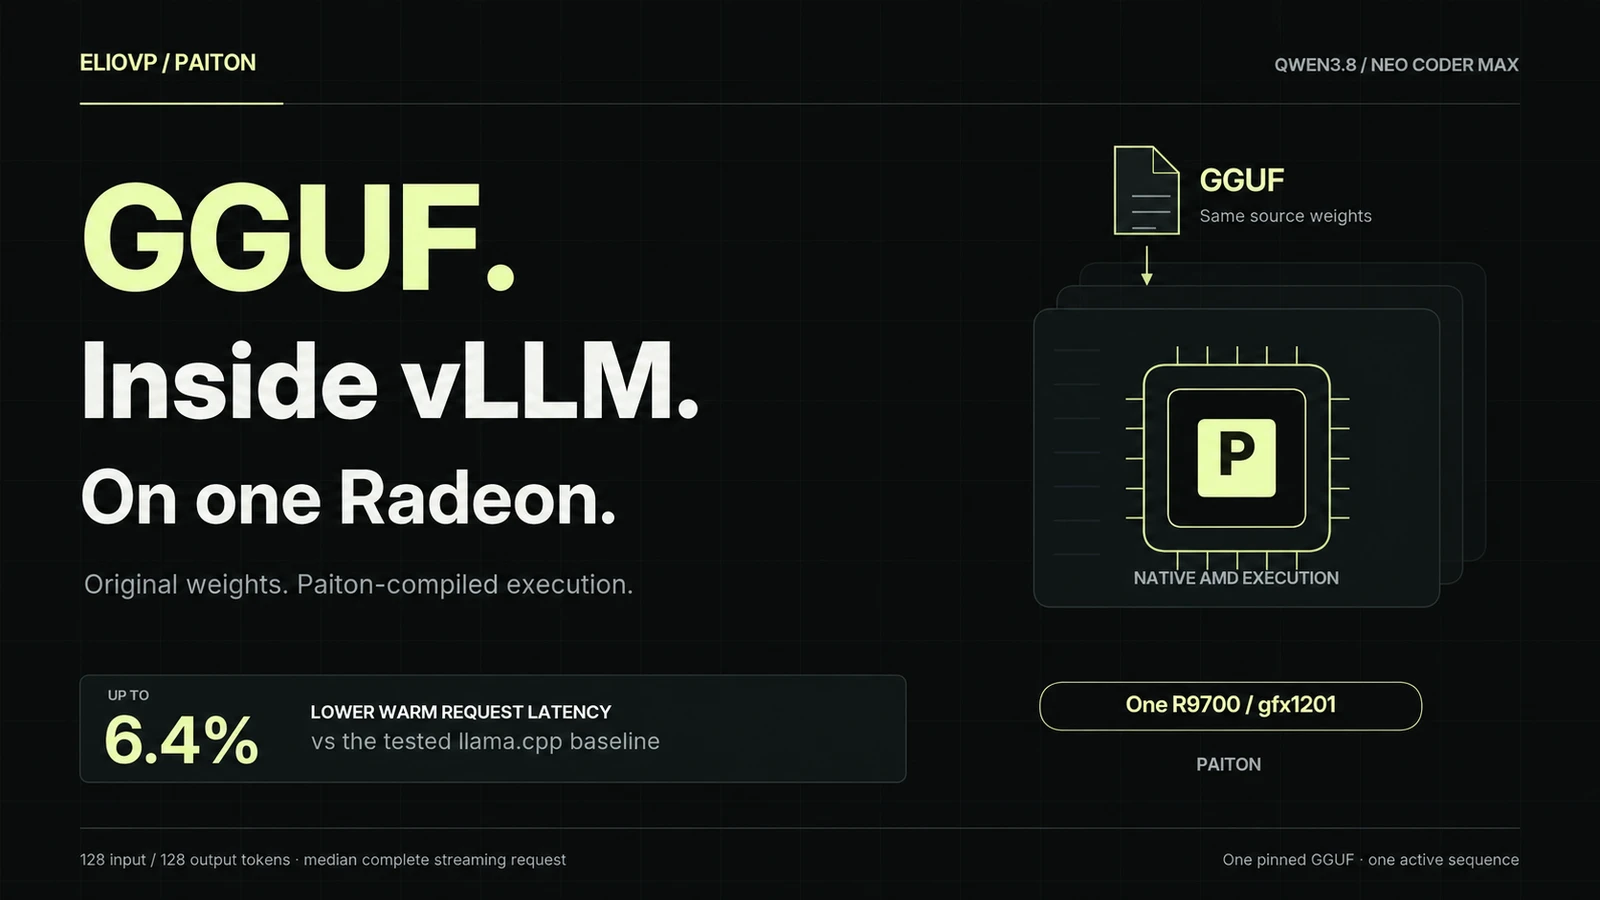
De originele NEO CODER MAX-gewichten. Uitvoering gecompileerd met Paiton. Tot 6,4% lagere responstijd voor opgewarmde verzoeken dan onze vergelijkbare llama.cpp-referentie op een Radeon AI PRO R9700.1
De originele GGUF-gewichten, daadwerkelijk geserveerd door vLLM. Uitvoering gecompileerd met Paiton op één Radeon AI PRO R9700.2
Qwen3.8 NEO CODER MAX van DavidAU krijgt veel aandacht. Op 14 september 2026 vermeldde de Hugging Face-repository 875.703 downloads in de voorgaande maand. Dat is het aantal downloads van de repository, niet het aantal unieke gebruikers. Het geeft wel een indruk van de belangstelling voor deze fine-tune.34
Wij wilden een andere vraag beantwoorden dan je in een doorsnee modelreview tegenkomt:
Kun je de originele GGUF-fine-tune behouden, via vLLM aanbieden en toch concurreren met llama.cpp op één Radeon?
Voor het geteste model en deze configuratie is het antwoord ja. Paiton voert het geselecteerde Q4_K_M-checkpoint met native AMD-code binnen vLLM uit. Verzoeken worden dus niet doorgestuurd naar een aparte llama.cpp-server.2
De fine-tune is van de maker. De uitvoering is van ons.
GGUF ondersteunen is niet hetzelfde als GGUF optimaal uitvoeren
vLLM ondersteunt GGUF al. Toch omschrijft de huidige documentatie die ondersteuning als zeer experimenteel en nog onvoldoende geoptimaliseerd, met mogelijke incompatibiliteiten met andere functies. De ondersteuning is inmiddels ondergebracht in de upstream vllm-gguf-plugin.5
Die plugin documenteert al verschillende modelfamilies, waaronder verwante Qwen-modellen voor tekst en beeld. We kondigen dus niet aan dat GGUF voor het eerst mogelijk is in vLLM.6
Onze doelstelling is specifieker: deze GGUF-fine-tune efficiënt op AMD-hardware laten draaien, zonder gebruikers naar een ander checkpoint of een ander serving-framework te laten overstappen.
GGUF is een container voor gewichten en metadata, geen verplichting om één bepaalde inference-engine te gebruiken.7 En llama.cpp heeft zelf al een OpenAI-compatibele server.8 Alleen een API-wrapper toevoegen zou hier niet de prestatie zijn.
Het verschil zit in echte vLLM-serving, met de gecompileerde native uitvoering van Paiton eronder.
Behoud de fine-tune. Verander de uitvoering.
Het geselecteerde checkpoint is de originele GGUF van de maker met gemengde Q4_K_M-kwantisatie, inclusief de tensors met hogere precisie en de BF16-outputlaag. We hebben het niet vervangen door het basismodel van Qwen of omgezet naar een nieuw AWQ-checkpoint.9
Paiton verzorgt de native uitvoering voor taal en beeld. vLLM behoudt de integratie voor het laden van het model, de planning van verzoeken, sampling en de streaminginterface. De compiler blijft gesloten; de publieke release bevat de runtimebestanden die nodig zijn om ermee te werken.2
Dit is een optimalisatie binnen een bestaande serving-stack. Je hoeft er geen andere inference-server voor te gebruiken.
De publieke integratie in het kort: behoud de GGUF van de maker, serveer via vLLM en voer uit met Paiton op de R9700. Dit is een integratieoverzicht, geen beschrijving van de interne werking van de compiler.2
Sneller een volledig antwoord, niet alleen een snellere kernel
De vergelijking hieronder meet volledige streaming-HTTP-verzoeken, met precies 128 gegenereerde tokens. Beide engines draaiden na elkaar op dezelfde R9700, zonder andere GPU-belasting. Per workload was er één opwarmverzoek, gevolgd door vijf gemeten verzoeken.10
Volledige streamingverzoeken, niet alleen kerneltijden. Beide engines genereren precies 128 tokens. Het resultaat bij 4.096 invoertokens is vrijwel gelijk; deze steekproeven van vijf verzoeken tonen geen statistische significantie aan.10
| Invoertokens | Mediaan llama.cpp | Mediaan Paiton + vLLM | Lagere responstijd |
|---|---|---|---|
| 128 | 5,264 s | 4,925 s | 6,4% |
| 1.024 | 5,933 s | 5,631 s | 5,1% |
| 4.096 | 9,099 s | 9,023 s | 0,8% |
Dit zijn metingen na het opwarmen, geen tijden voor een eerste installatie of koude start.10
Bij 4.096 invoertokens spreken we het best van vrijwel gelijke prestaties. Een verschil van 76 milliseconden tussen de medianen van een kleine steekproef rechtvaardigt geen brede prestatieclaim.
Een lagere totale responstijd betekent ook niet dat elk onderdeel van elk verzoek sneller is. llama.cpp wint nog steeds enkele tests met één uitvoertoken, waarbij vooral de verwerking van de invoer, of prefill, de tijd bepaalt.2
Het bruikbare resultaat is dat deze GGUF binnen vLLM kan blijven en toch concurrerende responstijden haalt. In deze gemeten tests met volledige antwoorden waren die tijden ook lager.
Wat bleef gelijk?
De vergelijking gebruikte dezelfde vastgelegde GGUF, de oorspronkelijke tokenizer, een context van 8.192 tokens, prefill-blokken van 2.048 tokens en een BF16-KV-cache. Beide engines hadden één actieve sequentie, uitgeschakelde MTP en prefixcaching, en greedy sampling met vaste aantallen tokens. llama.cpp was een ongewijzigde HIP-build, geen CPU-fallback.10
De prompts met vaste lengte zijn synthetische workloads voor tijdmetingen, geen benchmark voor programmeerproductiviteit. Korter redeneren of eerder stoppen wordt hier niet als snellere uitvoering meegeteld.10
Beeldinvoer werkt ook
Deze release accepteert ook één PNG- of JPEG-afbeelding via de chat-completions-interface. De beeldencoder draait via de native uitvoering van Paiton. Beeldembeddings en gegenereerde tekst delen hetzelfde contextbudget.11
Voor een afbeelding van 1.024 × 1.024 pixels en 128 uitvoertokens bedroeg de mediane totale responstijd 6,279 seconden met Paiton tegenover 6,455 seconden met llama.cpp, ongeveer 2,7% lager. Daarin zitten beeldverwerking, prefill voor het taalmodel, generatie en serving-overhead.2
Twee geteste beeldformaten, telkens gevolgd door 128 gegenereerde tokens. De tijd omvat beeldcodering, prefill voor het taalmodel, generatie en serving-overhead. Dit meet het begrijpen van beelden, niet het genereren ervan.10
| Beeldformaat | Mediaan llama.cpp | Mediaan Paiton + vLLM | Lagere responstijd |
|---|---|---|---|
| 256 × 256 | 5,111 s | 4,909 s | 4,0% |
| 1.024 × 1.024 | 6,455 s | 6,279 s | 2,7% |
Dit is inference met één afbeelding, geen ondersteuning voor video of onbeperkte aantallen afbeeldingen per verzoek.11
Dezelfde gewichten betekenen niet identieke berekeningen
Een ongewijzigd GGUF-checkpoint maakt twee runtimes niet numeriek identiek. Het geteste uitvoeringsprofiel gebruikt voor activaties andere berekeningen dan de oudere FP32-referentie. De gewichtswaarden blijven ongewijzigd.12
In de gepubliceerde controles slaagden 10 van de 11 vaste teksttaken, met dezelfde mislukte taak als bij llama.cpp, en alle vijf beeldtests. De laatste prefill-optimalisatie leverde bovendien overeenkomende waarden op voor 31.784.960 vergeleken logits ten opzichte van het voorgaande gevalideerde Paiton-profiel, niet ten opzichte van elke andere engine.1213
Dat zijn nuttige releasecontroles, geen bewijs dat de mogelijkheden voor elke programmeertaak, elk gesprek of elke afbeelding onveranderd zijn. We benoemen de numerieke vergelijkingen en hun referentieprofielen expliciet, in plaats van de release onder alle omstandigheden bit-identiek te noemen.
Het deploymentprofiel
De gepubliceerde release v1.1.0 is gevalideerd voor de volgende configuratie:1211
| Instelling | Ondersteund profiel |
|---|---|
| GPU | Eén Radeon AI PRO R9700, gfx1201 |
| Model | Vastgelegde originele NEO CODER MAX Q4_K_M GGUF |
| Runtime | Paiton; vastgelegde ROCm-versie 7.14.60850 |
| Context | In totaal 8.192 tokens |
| Actieve sequenties | Eén; extra HTTP-verzoeken komen in de wachtrij |
| Invoer | Tekst, of tekst met één PNG/JPEG-afbeelding |
| MTP, prefixcaching, video | Uitgeschakeld |
De modelnaam bevat MTP, maar deze resultaten gebruiken geen speculatieve MTP-decoding. Ook moet je clients in een wachtrij niet verwarren met gevalideerde GPU-batching van meerdere sequenties tegelijk.
Deze release richt zich op de R9700 met 32 GB. Dat is geen toezegging van ondersteuning voor een kleinere GPU, een andere GGUF-kwantisatie, langere contexten of veel gelijktijdige verzoeken.1
Start met de gepubliceerde release
Het gevalideerde lokale serving-profiel. Het API-paneel is illustratief, geen screenshot van een toepassing of benchmarkregistratie. Je hebt geen toegang tot de compiler nodig om de gepubliceerde runtime te gebruiken.12
Op een Linux-systeem met een R9700, een werkende AMD-driver en GPU-toegang vanuit Docker kun je de publieke repository met hulpscripts klonen en de vastgelegde containerimage van release v1.1.0 starten:112
git clone --depth 1 https://github.com/Eliovp-BV/paiton-vllm-plugin.git
cd paiton-vllm-plugin

PAITON_NEO_IMAGE=ghcr.io/eliovp/paiton-vllm-plugin@sha256:534287969135f581744ae481b578599468b0bf7ac9a4051b0941500e4c18da4d \
  ./models/Qwen3.8-NEO-CODER-MAX/serve-docker.sh
Bij de eerste start wordt ongeveer 19,43 GB aan vastgelegde model- en projectorbestanden gedownload. Latere starts hergebruiken de cache en controleren de hashes. De broncode van de compiler is niet nodig. Heb je al exact dezelfde vastgelegde GGUF, dan kun je die koppelen en hergebruiken volgens de instructies in de modelhandleiding.1
Zodra de server klaar is, kun je vanuit een andere terminal een verzoek sturen:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen38-neo",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function that removes duplicate integers while preserving their original order."
      }
    ],
    "temperature": 0,
    "max_tokens": 256,
    "stream": true,
    "chat_template_kwargs": {"enable_thinking": false}
  }'
Het voorbeeld schakelt thinking expliciet uit via het behouden oorspronkelijke template. Het is een interactief voorbeeld, niet het benchmarkverzoek met precies 128 uitvoertokens.1
Meer uit je hardware, zonder een andere serving-stack
Niet elk model heeft een nieuwe engine nodig. Een waardevolle fine-tune zou zijn identiteit niet moeten verliezen om efficiënt ingezet te kunnen worden.
In deze release blijven de originele GGUF en vLLM behouden. Paiton verandert de uitvoering die eronder ligt.2
Behoud de fine-tune. Behoud vLLM. Haal meer uit de Radeon die je al hebt.
Begin met de publieke modelhandleiding en het benchmarkrapport. Voor AMD-inference buiten dit gevalideerde profiel kun je met ons in gesprek over Paiton.1
Bronnen
- Paiton NEO-modelhandleiding. 2 3 4 5 6
- Native GGUF via vLLM op AMD RDNA4. 2 3 4 5 6 7
- Modelkaart van DavidAU, downloadcijfer gecontroleerd op 14 september 2026.
- Hugging Face: uitleg over downloadstatistieken.
- vLLM: GGUF-documentatie, geraadpleegd op 14 september 2026.
- Upstream vllm-gguf-plugin.
- Hugging Face: GGUF.
- llama.cpp.
- Vastgelegd checkpoint.
- Benchmarks voor NEO v1.1.0. 2 3 4 5 6
- Beeld-API. 2 3
- Releasemanifest v1.1.0. 2 3 4 5
- Publicatiecontroles.