Als een beeld op uw eigen werkstation wordt gegenereerd, kunt u de prompt aanpassen en meteen opnieuw proberen zonder het verzoek naar een cloudbeeldendienst te sturen. Met de uitgebrachte Qwen-Image 2.1 v1.0.2-bundel kan dat bij 2048 × 2048 pixels met 1 × Radeon AI PRO R9700 (32 GB).
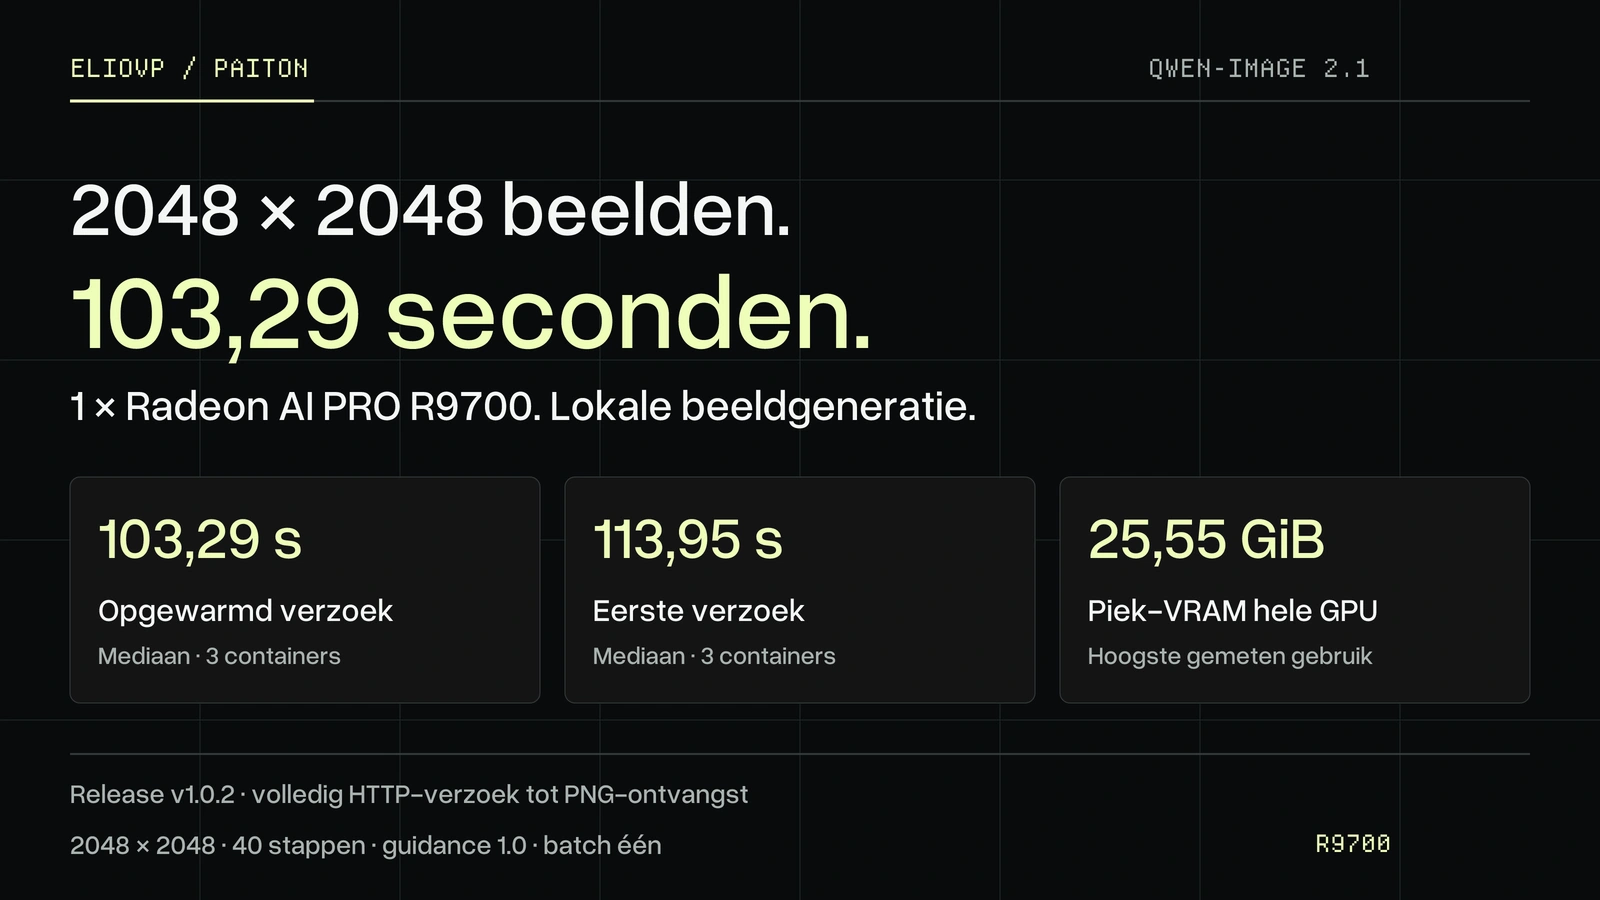
In drie nieuwe containers duurde een opgewarmd verzoek met het standaardprofiel mediaan 103,29 seconden, van het indienen van het beeldverzoek tot de ontvangst van de PNG. Dat is ongeveer 37% minder tijd dan de afzonderlijke, historische containerherhaling van v1.0.1 met 165,14 seconden. Het eerste verzoek duurde 113,95 seconden. Dit zijn gemeten releaseresultaten voor deze GPU en werklast, geen belofte voor elke prompt of andere kaart.
Het checkpoint, de resolutie en de 40 denoisingstappen blijven gelijk. De tekstencoder, het beeldmodel en de VAE blijven op de GPU: geen CPU-offload en geen VAE-tiling. Het standaardprofiel wint tijd door na de eerste zeven denoisingstappen bewust met lagere precisie te rekenen. Kies exact als meer precisiemarge belangrijk is. Beide opties zitten in de openbare container.12
Een volledig beeldverzoek gemeten
2048 × 2048 pixels, 40 stappen, guidance 1.0, batchgrootte één, ongewijzigd gebalanceerd MXFP4-checkpoint, één R9700 met 32 GB. De balken tonen de tijd van een volledig opgewarmd HTTP-verzoek tot de PNG-respons. Het gaat om afzonderlijke releaseherhalingen, niet om één gematcht experiment. Gepubliceerde metingen · grafiekgegevens.
| Gepubliceerde containerruntime | Opgewarmd verzoek | Eerste verzoek | Piek-VRAM | Metingen |
|---|---|---|---|---|
| v1.0.1 historische herhaling | 165,14 s | 179,32 s | 28,34 GiB | 3 processen |
v1.0.2 exact | 133,74 s | 147,83 s | 25,33 GiB | 1 container |
| v1.0.2 standaard | 103,29 s | 113,95 s | 25,55 GiB | 3 containers |
De tijden voor drie processen zijn medianen; exact is één validatierun. Het VRAM-cijfer is het hoogste gemeten gebruik van de volledige GPU tijdens de verzoeken van die rij, met een nominale meetinterval van 5 ms. De klok start bij het indienen van het verzoek en stopt na ontvangst van de volledige PNG-respons. Tekstcodering, beeldgeneratie, VAE-decodering en PNG-overdracht zijn inbegrepen. Het downloaden van het model en het opstarten van de server niet.
De 37% vergelijkt afzonderlijke herhalingen van gepubliceerde containerreleases. De bron bevat ook gecontroleerde, gematchte tests binnen v1.0.2, maar die hebben een andere steekproef en andere waarden. We voegen deze niet samen tot één gematchte benchmark. De eerdere kwalificatiemeting van 103,64 seconden is iets anders dan de 103,29 seconden van de gepubliceerde container hierboven.2
Begin op uw R9700
Liever een visuele werkomgeving? Paiton Studio brengt ondersteunde lokale tools voor beeld, video en tekst samen in uw browser. Controleer in de actuele toollijst welke modellen beschikbaar zijn. De commando's hieronder starten de specifieke Qwen-Image 2.1-container die in dit artikel is gemeten.
U hebt Linux, Docker, een werkend AMD GPU-stuurprogramma en minstens 30 GiB vrij GPU-geheugen vóór het laden nodig. Draai één beeldworker tegelijk. Bij de eerste start worden ongeveer 9,33 GB checkpointbestanden gedownload en gecontroleerd; latere starts hergebruiken de cache. Vanuit een checkout van de openbare modelhandleiding:1
git clone https://github.com/Eliovp-BV/paiton-vllm-plugin.git
cd paiton-vllm-plugin
git checkout 6586aa618610aed596d2720fbb5768c181bf1011
./models/Qwen-Image-2.1/serve-docker.sh
Wacht op het bericht READY. Dien in een tweede terminal een prompt in en sla de PNG op:
python3 models/Qwen-Image-2.1/request.py \
  --prompt 'A neon shop sign that reads "QWEN IMAGE 2.1", rainy night, reflections on wet pavement' \
  --size 2048 --seed 42 --output outputs/neon.png
Voer de client uit vanuit dezelfde repositorymap. Geef elk nieuw verzoek een nieuwe uitvoerbestandsnaam; de client overschrijft geen bestaande afbeelding.
Wilt u meer precisiemarge, stop dan de standaardworker en start dezelfde release met het profiel exact:
./models/Qwen-Image-2.1/serve-docker.sh serve --precision-profile exact
De enige containercontrole van dat profiel mat 133,74 seconden per opgewarmd verzoek. De beeld-API accepteert ook JSON via POST http://127.0.0.1:8191/v1/images/generations. De meegeleverde request.py-client verwerkt de base64-respons en bewaart de PNG. Deze beeld-API staat los van de taalmodelprofielen van paiton serve; gebruik voor dit model de commando's hierboven.1
De gekwalificeerde bundel ondersteunt ook transparante PNG's op 1024 of 2048 pixels vierkant en de bewerking van één invoerbeeld naar een uitvoerbeeld van 1024 pixels vierkant. Voor die modi gelden eigen kwaliteits- en prestatiegrenzen. De 103,29 seconden slaan op de tekst-naar-beeldwerklast hierboven.
Waarom standaard sneller is en wanneer exact nuttig is
De modelgewichten veranderen niet tussen deze runtimeprofielen. In het standaardprofiel gebruiken de verwerking van de tekstprefix en de eerste zeven denoisingstappen het exacte pad. De latere stappen rekenen met lagere precisie. Daardoor duurt de generatie korter, terwijl de eerste stappen, die de compositie sterk bepalen, de rekenprecisie van het exact-profiel voor hetzelfde gekwantiseerde checkpoint behouden. exact gebruikt die rekenwijze tijdens alle 40 stappen.12
Het standaardprofiel slaagde voor een afgebakende kwaliteitscontrole tegenover beelden uit het eigen exact-profiel. Er is niet vergeleken met de oorspronkelijke niet-gekwantiseerde BF16-gewichten. De test garandeert evenmin identieke pixels of kwaliteit bij elke prompt. De transparante RGBA-test op 2048 pixels haalde de grens maar nipt: 35,02 dB PSNR bij een drempel van 35 dB. Voor transparant werk of andere toepassingen waarbij meer marge gewenst is, kiest u exact, dat in de containercontrole ongeveer 134 seconden opgewarmd kostte. De handleiding beschrijft ook het tussenprofiel schedule-int8-11.2
In beide profielen blijven alle modelonderdelen op de GPU. De gemeten pieken van 25,55 GiB (standaard) en 25,33 GiB (exact) betreffen de volledige GPU. Het zijn geen downloadgroottes en ze garanderen niet dat een kleinere kaart werkt. De launcher kwalificeert de R9700 met RDNA4 gfx1201, niet elke Radeon of elke GPU met 32 GB.13
Bekijk de release en de licenties
De installatiehandleiding bevat de actuele container, directe generatie, bewerking en offline instructies. Het benchmarkrapport toont de metingen per run, het geheugen, de kwaliteitscontroles en de grenzen. De Hugging Face-modelkaart biedt het checkpoint. De v1.0.2-runtime komt uit de openbare container, niet uit de oorspronkelijke loader op die modelkaart.
Voor de modelgewichten geldt de Qwen Research License: niet-commercieel onderzoek en evaluatie zijn toegestaan, terwijl commercieel gebruik een aparte upstreamlicentie vereist. Voor de Paiton-runtime en adapter gelden afzonderlijke Apache-2.0-voorwaarden. Controleer beide voordat u het model inzet. De container downloadt de modelgewichten afzonderlijk bij het opstarten.13
Deze release vormt een extra optie voor lokale beeldgeneratie naast ons FLUX.2 klein-profiel. De meetgrens, het model, de instellingen en de licentie zijn anders; de hoofdcijfers vormen dus geen rechtstreekse vergelijking. Ontdek Paiton of neem contact met ons op om een AMD-beeldwerklast te bespreken.