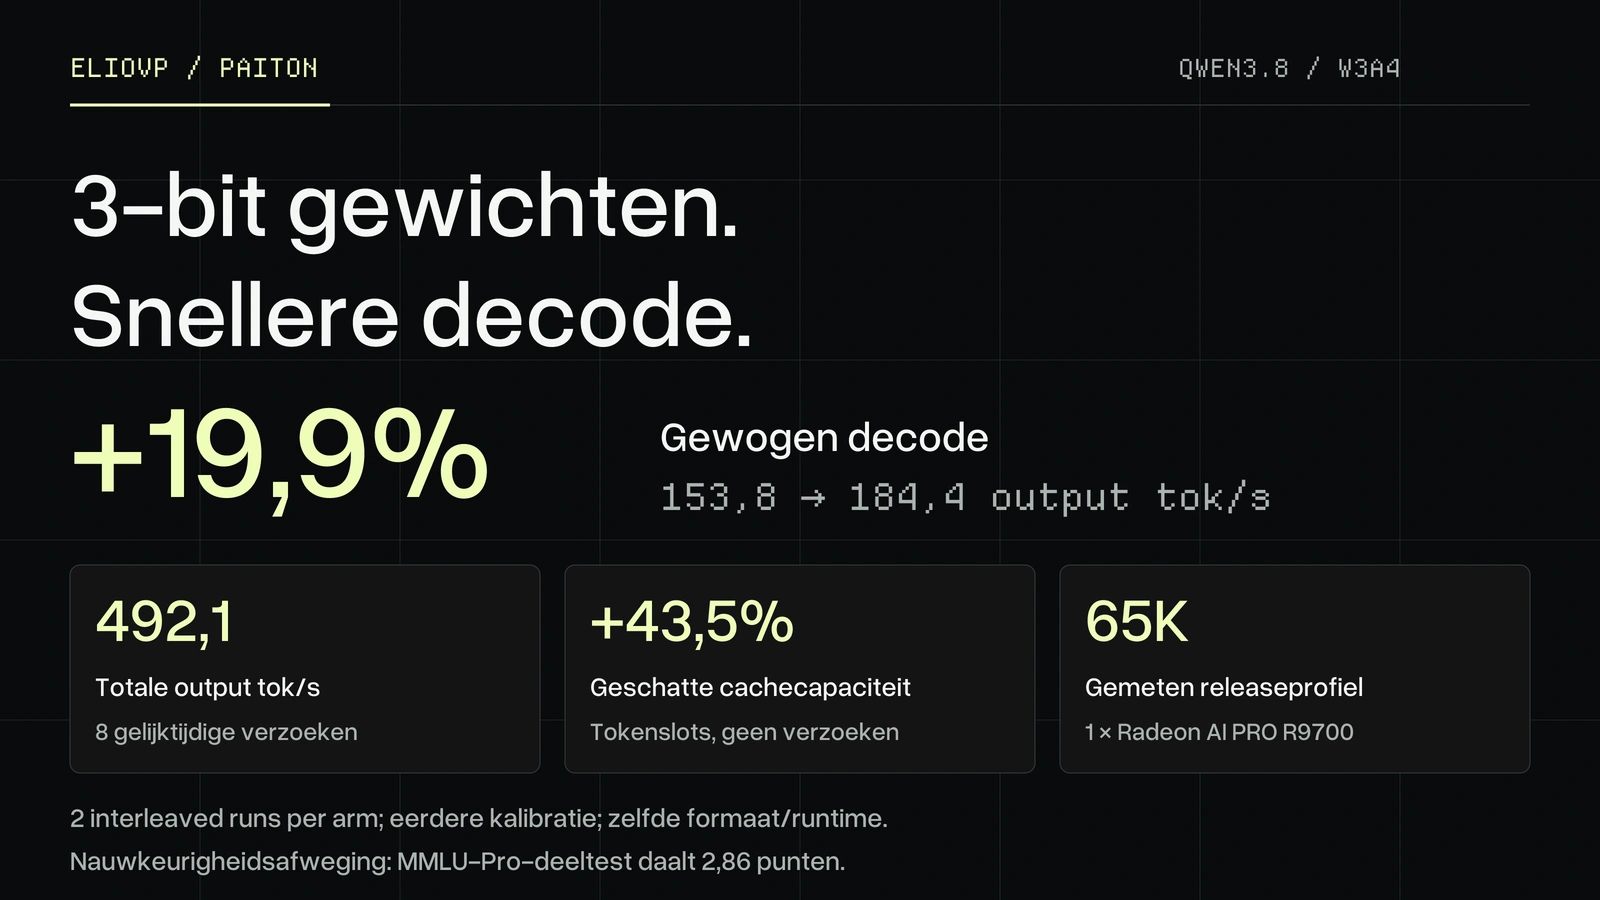
Een lokale assistent is nuttiger als hij sneller schrijft, lange documenten sneller verwerkt en ruimte heeft voor meerdere gebruikers tegelijk. Onze Paiton-release brengt die verbeteringen naar Qwen3.8 27B op 1 × Radeon AI PRO R9700 (32 GB), zonder een tweede GPU toe te voegen.
In de oorspronkelijke benchmark van 26 september steeg de gewogen generatiesnelheid tegenover onze MXFP4-release van 24 september van 153,8 naar 184,4 tokens per seconde: 19,9% snellere decode. Acht gelijktijdige verzoeken leverden samen 492,1 tokens per seconde, tegenover 425,3. De kleinere gewichten boden met de FP8-cache in het 65K-serverprofiel aanvankelijk 43,5% meer gerapporteerde cachecapaciteit in tokens. De huidige image voegt een 4-bit cache toe en vergroot die gerapporteerde capaciteit verder.12
De verandering bestaat uit onze eigen geroteerde 3-bit gewichten voor de grote decoderprojecties, met 4-bit activatierekenwerk in geselecteerde lagen tijdens de promptverwerking. Andere tensors behouden hun bestaande formaat. Daar staat een echte afweging tegenover: de MMLU-Pro-subset voor algemene kennis daalt in de oorspronkelijke vergelijking met MXFP4 met ongeveer drie procentpunten. De verschillen voor rekenen en code zijn in die tests niet te onderscheiden van meetruis, en alle 80 afgebakende lang-contextopzoektests slagen. Als kennisnauwkeurigheid vooropstaat, blijft MXFP4 via één opstartoptie beschikbaar.
Update van 30 september: één image, meer manieren om te draaien
De huidige releasehandleiding beschrijft één image, op 29 september bijgewerkt naar r2. De tekstmodus met 65K context ondersteunt nog steeds maximaal acht ingeplande verzoeken. Met W3A4-gewichten staat de nieuwe 4-bit attention-cache standaard aan; --kv-cache fp8 herstelt de cachekeuze van de oorspronkelijke benchmark. Dezelfde image kan in plaats daarvan één gesprek van 200K tokens met prefixcaching draaien, of met --vision afbeeldingen ontvangen in de 65K-modus. Deze modi hebben elk hun eigen geheugen- en prestatiekenmerken. Beeldinvoer kan niet worden gecombineerd met de geteste lang-contextmodus.2
De image van 26 september achter de grafieken hieronder kon onder bepaalde gelijktijdige belasting stoppen. De r1-image van 28 september verhielp dat probleem, maar die en eerdere images hadden nog een afzonderlijke fout bij het initialiseren van de DFlash2-draftkop. Daardoor kon de acceptatie van speculatieve tokens op sommige systemen instorten. Gebruik voor nieuwe installaties de r2-image van 29 september. De launcher legt de image vast via een digest; de installatie hieronder legt ook de repository en gewichten vast. De metingen van 26 september blijven historische metingen, geen nieuwe benchmark van elke r2-modus.2
Wat verandert in dagelijks gebruik
De release van 26 september combineerde het bestaande MXFP4-pad, de FP8-cache, DFlash2-speculatieve decode en Paitons native AMD-uitvoering binnen vLLM met optionele kleinere W3A4-gewichten. Dat leverde snellere uitvoer, snellere promptverwerking en meer cacheruimte op dezelfde kaart op. De latere image voegt cachecompressie en een keuze tussen modi toe.
Die voordelen zijn verschillende metingen. Decode is de generatie na het eerste token. Totale doorvoer is de uitvoer van meerdere gelijktijdige verzoeken samen. Prefill is het verwerken van de prompt voordat de generatie begint. Een hogere tokensnelheid in één fase betekent niet automatisch een even grote daling van de volledige verzoektijd.
De 19,9% uit de titel vergelijkt deze release met de MXFP4-image van 24 september, niet met de oudere Radiance-vergelijking in ons eerdere Qwen3.8-artikel. Het oorspronkelijke resultaat van 57% in dat artikel blijft een afzonderlijke benchmark met een eigen configuratie.
Snellere generatie in uiteenlopende taken
BetterBench 0.6.0, quick-profiel. Generatie na het eerste token, in tokens/s; hoger is beter. De waarden zijn gemiddelden van twee volledige runs. Het gewogen resultaat stijgt met 19,9% tegenover de vorige release. De winst verschilt per taak en belooft dus niet dat elke prompt 20% sneller genereert. Gepubliceerd benchmarkrapport.
| Taak | Vorige MXFP4-release | Deze ronde, MXFP4 | W3A4-release | Verschil tegenover vorige |
|---|---|---|---|---|
| Chat | 121,2 tok/s | 122,9 tok/s | 135,8 tok/s | +12,0% |
| Code | 179,9 tok/s | 182,7 tok/s | 226,0 tok/s | +25,6% |
| Bestandsbewerking | 179,9 tok/s | 182,7 tok/s | 195,0 tok/s | +8,5% |
| JSON | 217,5 tok/s | 220,8 tok/s | 269,0 tok/s | +23,7% |
| Rekenen | 183,8 tok/s | 186,5 tok/s | 228,9 tok/s | +24,5% |
| Proza | 78,5 tok/s | 79,6 tok/s | 94,7 tok/s | +20,7% |
| Redeneren | 117,8 tok/s | 119,4 tok/s | 133,5 tok/s | +13,3% |
| Samenvatten | 138,4 tok/s | 140,5 tok/s | 158,4 tok/s | +14,4% |
| Gewogen | 153,8 tok/s | 156,1 tok/s | 184,4 tok/s | +19,9% |
De middelste kolom scheidt de kleinere runtimeverbeteringen met MXFP4 van de grotere winst door het nieuwe gewichtformaat. De gewogen decode van het MXFP4-pad van deze ronde ligt ongeveer 1,5% boven de vorige release.
Meer uitvoer bij overlappende verzoeken
Totale gegenereerde tokens/s, met 48 verzoeken per gelijktijdigheidsniveau; hoger is beter. Dit zijn gezamenlijke serversnelheden, niet de snelheid die elke gebruiker afzonderlijk krijgt. Eén R9700, 65.536 tokens ingestelde context, maximaal acht ingeplande reeksen.
| Gelijktijdige verzoeken | Vorige MXFP4-release | W3A4-release | Verschil |
|---|---|---|---|
| 1 | 122,0 tok/s | 148,8 tok/s | +22,0% |
| 2 | 204,2 tok/s | 249,3 tok/s | +22,1% |
| 4 | 308,2 tok/s | 368,3 tok/s | +19,5% |
| 8 | 425,3 tok/s | 492,1 tok/s | +15,7% |
Voor een gedeelde lokale assistent kan de GPU zo meer uitvoer leveren terwijl verzoeken overlappen. De precieze winst hangt af van de promptlengtes, uitvoerlengtes en beschikbare cache.
Ook de promptverwerking wordt sneller
Verwerkte invoertokens per seconde; hoger is beter. De dieptelabels zijn nominale BetterBench-instellingen, geen exacte promptlengtes. De grootste nominale 64K-werklast heeft mediaan 47.016,5 werkelijke prompttokens. De gemeten wachttijd tot het eerste token staat apart hieronder.
| Nominale diepte | Mediaan werkelijke prompttokens | Vorige MXFP4-release | W3A4-release | Verschil |
|---|---|---|---|---|
| 2K | 1.516,5 | 3.689 tok/s | 4.156 tok/s | +12,7% |
| 8K | 5.894,5 | 3.834 tok/s | 4.165 tok/s | +8,6% |
| 16K | 11.802 | 3.871 tok/s | 4.103 tok/s | +6,0% |
| 32K | 23.549,5 | 3.751 tok/s | 3.958 tok/s | +5,5% |
| 64K | 47.016,5 | 3.455 tok/s | 3.629 tok/s | +5,0% |
De geteste prefill-snelheden verbeteren met 5,0–12,7%. De clientwachttijd tot het eerste token daalt met 4,8–10,8%, op basis van het gemiddelde van de mediane TTFT van beide runs. Een hogere doorvoer en een lagere wachttijd zijn verschillende percentages. Ook planning en andere overhead kunnen de wachttijd beïnvloeden.3
| Nominale diepte | Vorige TTFT, gemiddelde van runmedianen | W3A4 TTFT, gemiddelde van runmedianen | Minder wachten |
|---|---|---|---|
| 2K | 407,453 ms | 363,395 ms | 10,8% |
| 8K | 1.548,047 ms | 1.416,748 ms | 8,5% |
| 16K | 3.054,554 ms | 2.877,005 ms | 5,8% |
| 32K | 6.270,297 ms | 5.943,109 ms | 5,2% |
| 64K | 13.617,798 ms | 12.962,238 ms | 4,8% |
Meer ruimte voor lange gesprekken
Oorspronkelijke vergelijking van 26 september met de FP8-cache. Het modelgeheugen daalt van 19,18 naar 15,89 GiB. De launcher gebruikt het vrijgekomen geheugen voor de gesprekscache: van 174.634 naar 250.578 gerapporteerde tokenplaatsen. De huidige standaardinstelling voor W3A4 in de 65K-modus gebruikt in plaats daarvan een 4-bit cache; zie hieronder. Cachecapaciteit is een schatting uit de serverconfiguratie, geen aantal volledig gemeten gesprekken.
| Geheugenonderdeel | Vorige MXFP4-release | W3A4-release |
|---|---|---|
| Modelgeheugen | 19,18 GiB | 15,89 GiB |
| Gerapporteerde cachecapaciteit in tokens | 174.634 | 250.578 |
| Omgerekende capaciteit bij 65.536 tokens per reeks | Ongeveer 2,7 | Ongeveer 3,8 |
De laatste rij is een omgerekende capaciteitsschatting, geen bewering dat 3,8 verzoeken kunnen draaien. Prompttekst, chat- en toolopmaak en gegenereerde uitvoer tellen allemaal mee in de context. Acht ingeplande reeksen betekenen evenmin dat acht volledige 65K-gesprekken tegelijk passen.1
We testten het praktische effect apart met vier prompts van ongeveer 61.400 tokens, elk met 512 aangevraagde uitvoertokens. De werkelijke promptlengtes lopen van 61.390 tot 61.426 tokens. Met het oorspronkelijke cachebudget passen slechts twee van deze verzoeken tegelijk. Als W3A4 het vrijgekomen geheugen als cache gebruikt, kunnen ze alle vier tegelijk decoderen:
Vier lange verzoeken op één R9700. Voor de volledige batchtijd is lager beter. De controle gebruikt de MXFP4-build van 26 september, niet de image van 24 september. W3A4 met uitgebreide cache verandert het geheugenbudget en gebruikt de uitgebrachte kalibratie. De W3A4-controle met dezelfde cache gebruikte een eerdere kalibratie.
| Lang-contextmeting | MXFP4 | W3A4, hetzelfde cachebudget | W3A4, uitgebreide cache |
|---|---|---|---|
| Decode terwijl alle actieve verzoeken draaien | 69 tok/s, 2 actief | 117 tok/s, 2 actief | 199 tok/s, 4 actief |
| Alle vier tegelijk decoderen | Nee, twee tegelijk | Nee, twee tegelijk | Ja |
| Batchtijd, 4 × 61K-prompts + elk 512 tokens | 105,6 s | 92,9 s | 86,2 s |
De nieuwe gewichten versnellen de decode met twee verzoeken ook zonder extra cache. Het herverdelen van geheugen verkort daarna de wachttijd voor de volledige batch van vier verzoeken. De 199 tok/s is de gezamenlijke decode terwijl alle vier actief zijn, niet de doorvoer over de volledige batch. In deze oorspronkelijke test met de FP8-cache was het piekgebruik van de volledige GPU 31,39 GiB met W3A4 tegenover 31,37 GiB voor de MXFP4-controle. Er blijft dus weinig vrije marge op deze kaart. Dit is één lang-contextwerklast, geen algemene garantie voor elk aantal gelijktijdige gebruikers.3
De huidige 65K-modus: een 4-bit cache voor meer gelijktijdig werk
De nieuwere image bewaart de keys en values van full attention in 4 bits wanneer W3A4-gewichten en de standaard 65K-modus zijn geselecteerd. De 4-bit cache is niet de standaard voor MXFP4, de 200K-modus met één verzoek of het desktopprofiel. Daardoor kan de vLLM-planner meer van dezelfde kaart gebruiken; de contextlimiet per verzoek verdubbelt niet. Het opstartlog van vLLM meldt 393.216 cachetokens, tegenover 250.578 met W3A4 plus FP8. Na aftrek van andere status per verzoek stijgt het budget voor attention-tokens bij acht verzoeken van 211.136 naar 358.336, of 1,70×.2
| Aparte 65K-cachetest op één R9700 | Image 26 sept., W3A4 + FP8 | Image 28 sept., W3A4 + 4-bit |
|---|---|---|
| Vier verzoeken van ongeveer 61K tokens, gezamenlijke decode terwijl alle vier draaien | 188 tok/s | 219 tok/s |
| Zes verzoeken van ongeveer 61K tokens | Niet allemaal tegelijk toegelaten | Alle zes, samen 248 tok/s |
| Acht verzoeken van ongeveer 32K tokens | Niet allemaal tegelijk toegelaten | Alle acht, samen 339 tok/s |
Dit is gezamenlijke decode terwijl alle verzoeken actief zijn, geen snelheid per gebruiker of doorvoer over de volledige batch. In deze gepaarde test bedraagt het FP8-resultaat met vier verzoeken 188 tok/s, tegenover 199 tok/s in de eerdere test hierboven. Vergelijk de twee configuraties binnen dezelfde test, niet tussen verschillende runs. Deze cachemetingen dateren van vóór de r2-oplossing voor de draftkop. De 4-bit cache verbeterde de decode met één verzoek of de wachttijd tot het eerste token niet meetbaar. Gepaard met de FP8-cache zagen we geen verlies op GSM8K, HumanEval, de MMLU-Pro-subset of de 61K-needle-opzoektest, maar zulke afgebakende controles bewijzen geen identieke kwaliteit. Ook in een test met 24 synthetische sessies van codeagents vielen de verschillen binnen de meetruis.2
Een afzonderlijke 200K-gespreksmodus en optionele beeldinvoer
De huidige verenigde image kan één gesprek van maximaal 200.000 tokens in totaal draaien, met een FP8-cache van 8 GiB en prefixcaching. De releasehandleiding vermeldt 94 seconden tot het eerste token voor een nieuwe prompt van 198.989 tokens met W3A4, 102 seconden voor MXFP4 in de verenigde image en 115 seconden voor de vroegere afzonderlijke 200K-image; ze noemt dit geen nieuwe r2-meting. Een vervolgvraag die de ongewijzigde prefix hergebruikt, duurde 1,2 seconden. Op die lengte haalde W3A4 73–78 tokens/s tijdens decode. Het team testte ook een prompt van 215K tokens met een instelling van 220K, maar niet het volledige modelvenster van 262K. De controles met geplante feiten en toolaanroepen slaagden; het is geen brede kwaliteitsbeoordeling van lange gesprekken. Cachehits vereisen een ongewijzigde prefix die nog in het geheugen aanwezig is.2
Voor beeldinvoer laadt --vision de vision-encoder van het checkpoint, alleen in de 65K-modus. Die werd gecontroleerd met schermafbeeldingen van code, een falende test, een formulier en een grafiek, ook met acht gelijktijdige beeldverzoeken. De encoder gebruikt geheugen dat anders voor de cache beschikbaar is: de combinatie W3A4 + 4-bit meldt met beeldinvoer 278.050 cachetokens, tegenover 393.216 zonder. Video en beeldinvoer in de lang-contextmodus met prefixcaching zijn niet gekwalificeerd.2
Wat we veranderden en waarom
Eerst de bestaande runtime voorspelbaar maken
Voordat we de gewichten veranderden, onderzochten we serverstarts die ondanks dezelfde configuratie afwisselden tussen ongeveer 28 en 36 ms per speculatieve stap. Door de runtime met GPU_MAX_HW_QUEUES=1 aan één hardware-computewachtrij te koppelen, bleven die starts in de snellere modus. De image bevat die instelling. Alle vergelijkingsarmen gebruikten die al, zodat de winst door deze instelling niet in het hoofdcijfer zit.
We voegden ook de GatedDeltaNet-bewerking voor speculatieve verificatie samen in één native kernel. Die afzonderlijke bewerking werd 23–28% sneller; de gecombineerde runtimeverbeteringen verhogen de volledige gewogen MXFP4-decode met ongeveer 1,5%. Winst in één kernel is niet hetzelfde als winst in de volledige generatie.
Minder bytes lezen tijdens generatie
Decode op deze kaart wordt vooral begrensd door de geheugenbandbreedte. De vorige kernels zaten al dicht bij de beschikbare bandbreedte. Minder gewichtdata lezen bood daarom meer ruimte dan alleen de planning aanpassen.
De grote lineaire projecties gaan van ongeveer 4,25 bits per gewicht met MXFP4 naar 3,125 bits met gegroepeerde INT3. Dit betreft 24,3 miljard decoderprojectiegewichten, niet elke tensor in het 27B-model, en is ruwweg een kwart minder data voor die gewichten. Native Paiton-kernels verwerken de verpakte waarden rechtstreeks. Decode houdt 8-bit FP8-activaties; in de serververgelijking daalt de mediane forwardtijd met één stroom van ongeveer 28,3–28,4 ms naar 22,4–22,5 ms.13
Andere precisie gebruiken voor promptverwerking
Promptverwerking heeft een ander knelpunt. Alleen 3-bit gewichten combineren met het oude pad voor 8-bit activaties maakte die fase in onze controles trager. De release gebruikt daarom 4-bit activatierekenwerk alleen in geselecteerde prefill-projecties. Tijdens generatie blijven de activaties 8-bit.
Een bloksgewijze Hadamard-rotatie verdeelt grote activatieuitschieters over kleine groepen, zodat promptverwerking met lagere precisie bruikbaar wordt. De gewichten worden in die geroteerde basis gekalibreerd; de runtime past de overeenkomstige activatietransformatie toe. Schalen per groep behoudt meer lokale precisie dan één schaal voor een volledig token. Dit is de openbare methode achter de naam W3A4, geen nieuwe modelarchitectuur.1
Onze eigen gewichten kalibreren en datalicenties controleren
Dit zijn onze eigen met GPTQ gekalibreerde gewichten; een 3-bit model van een derde partij is niet vereist. De kalibratie gebruikt 292.864 tokens uit rekenen, code, wetenschap, webtekst, meertalig materiaal, agenttraces en lange documenten. Het laag-voor-laagproces duurt ongeveer 13 minuten op één AMD Instinct MI355X.
Voor de release vervingen we kalibratiebronnen met niet-commerciële of share-alikevoorwaarden door bronnen met permissieve licenties. De uitgebrachte gewichten gebruiken die definitieve kalibratie. Het kalibratierapport vermeldt de datasetrevisies en licenties. De vermeldingen voor derden behouden de verplichte bronvermeldingen.
Opstarten en integriteitscontroles duidelijk houden
De runtime laadt de geroteerde vervangingsgewichten naast het vastgelegde basischeckpoint en controleert hun bestanden via SHA-256. Een apart 3-bit model van derden is niet nodig. We verholpen ook een opwarmprobleem waarbij niet-geïnitialiseerde dummyinvoer vóór het eerste echte verzoek een vlag voor niet-eindige waarden kon activeren. Die vlag wordt na de opwarming gewist, terwijl de strikte controles voor echte verzoeken actief blijven.
Met een opgewarmde runtimecache startte de image van 26 september in ongeveer 230 seconden, tegenover ongeveer 210 seconden eerder. De huidige image kan bij de eerste start met een lege runtimecache ongeveer zeven minuten nodig hebben. De winst tijdens opgewarmde uitvoering neemt die eerste voorbereidingstijd niet weg.2
Kwaliteit: de winst vraagt een keuze
Nauwkeurigheid in het draaiende model, met greedy decode, uitgeschakeld denken en identieke vragen. De gepaarde 95%-betrouwbaarheidsintervallen bevatten nul voor GSM8K en HumanEval, maar niet voor de MMLU-Pro-subset. De 80 needle-tests controleren gericht informatie ophalen, niet de volledige kwaliteit bij lange contexten.
| Benchmark | MXFP4 | W3A4 | Verschil en gepaard 95%-betrouwbaarheidsinterval |
|---|---|---|---|
| GSM8K, 5-shot, 1.319 vragen | 95,68% | 95,30% | −0,38 punten −1,44, +0,68 |
| HumanEval pass@1, 164 taken | 95,12% | 93,90% | −1,22 punten −4,99, +2,56 |
| MMLU-Pro-subset, 0-shot, 14 × 100 vragen | 62,57% | 59,71% | −2,86 punten −4,81, −0,90 |
| Needle-opzoektest op 61.440 tokens, 80 controles | 100% | 100% | Geen waargenomen verschil |
Rekenen en code blijven dicht bij elkaar in de geteste sets; de intervallen bewijzen geen identieke kwaliteit. Meerkeuzevragen met veel algemene kennis tonen wel een meetbare daling van ongeveer drie punten. Ook de acceptatie van DFlash2 blijft dichtbij, met veranderingen per taak van −0,4% tot +2,8%.1
Kies voor kennisintensief werk --weights mxfp4. Dat gebruikt het gewichtpad met hogere precisie en krijgt nog steeds de MXFP4-runtimeverbeteringen van deze ronde. W3A4 is nuttig als snellere generatie en meer gesprekscache de gemeten kwaliteitsafweging waard zijn. De uitvoer kan verschillen; we beloven geen identieke antwoorden.
Meertalige kwaliteit, tool-calling en kwaliteit bij langere contexten zijn niet gemeten in de oorspronkelijke vergelijking tussen W3A4 en MXFP4. Die oorspronkelijke doorvoer- en gepaarde nauwkeurigheidsresultaten gelden voor het 65K-tekstprofiel, niet voor elke modus van de huidige image. De nieuwere release heeft afzonderlijke, afgebakende controles voor 200K-gesprekken, toolaanroepen en beeldinvoer bij 65K; daaruit volgt geen brede kwaliteitsgelijkheid. W3A4 blijft specifiek voor de R9700 en vereist de Paiton-runtime: standaard-vLLM, Transformers en llama.cpp kunnen de vervangingsgewichten niet zelfstandig laden.12
Zo leest u deze resultaten
De prestatievergelijking gebruikt één R9700 met een vermogenslimiet van 300 W, vLLM 0.29, ROCm 10, een context van 65.536 tokens, maximaal acht reeksen, DFlash2 en uitgeschakeld denken. Automatische prefixcaching en n-gram co-drafting staan uit. Elke image draaide in twee nieuwe serverprocessen, afwisselend uitgevoerd, en de tabellen tonen het gemiddelde van die twee runs. BetterBench gebruikte versie 0.6.0 en het quick-profiel. De referentie-image is qwen38-rocm10-vllm029-65k-20260924-r3.
De oorspronkelijke openbare prestatieruns gebruikten de eerdere v3-kalibratie. De oorspronkelijke nauwkeurigheidscijfers en de run met vier verzoeken en uitgebreide cache gebruiken de definitieve, permissief gekalibreerde gewichten. Het tensorformaat en de runtime zijn identiek, maar niet alle tests gebruiken precies dezelfde gewichtsbytes. Gegenereerde tekst en speculatieve acceptatie kunnen verschillen: W3A4 veranderde zeven van twaalf greedy controleresultaten tegenover MXFP4. Dit zijn metingen van serverdoorvoer, geen tijden voor identieke uitvoer. Procentuele verschillen zijn berekend uit niet-afgeronde metingen; narekenen vanuit de afgeronde tabellen kan daarom licht afwijken.13
De gewogen decode van BetterBench geeft code 30%, redeneren 20%, proza en JSON elk 15%, en bestandsbewerking en samenvatten elk 10%. Chat en rekenen worden apart getoond en tellen niet mee in het hoofdcijfer. Elke run meet na vaste opwarmverzoeken vijf verzoeken per decodecategorie, 48 per gelijktijdigheidsniveau en acht per nominale prefill-diepte. Bestandsbewerking varieert het meest tussen de twee W3A4-runs: 179,0 en 211,1 tok/s. Het volledige rapport en de brondata bewaren die meetdetails.
De 300 W is de ingestelde vermogenslimiet van de GPU. We hebben geen energieverbruik van het volledige systeem of kosten per token gemeten. Snellere generatie is op zichzelf geen meting van elektriciteitsbesparing. De resultaten hierboven voor de 4-bit cache, 200K en beeldinvoer komen uit afzonderlijke controles, niet uit de oorspronkelijke BetterBench-tabellen. In een vergelijking in de releasehandleiding lag de 65K-prefill van de image van 28 september binnen ±0,3% en de gezamenlijke doorvoer binnen −2,4% tot 0,0% van de image van 26 september. Dat maakt de oorspronkelijke 492,1 tok/s niet tot een nieuwe meting van r2.2
Probeer het op uw R9700
Gebruik Linux x86-64, Python 3, Docker, de Hugging Face CLI en AMD GPU-toegang. Reken op ongeveer 75 GB schijfruimte voor de image en drie modelpakketten. De commando's hieronder leggen de huidige openbare launchercheckout en de revisies van target, drafter en geroteerde gewichten samen vast. Hebt u de pluginrepository al, gebruik dan een aparte checkout in plaats van lokaal werk te vervangen. De releasehandleiding beschrijft bestaande downloads en andere profielen.2
git clone https://github.com/Eliovp-BV/paiton-vllm-plugin.git
cd paiton-vllm-plugin
git checkout 86ff71c4a3ccaa5da410c2b94e1976fab1c6ab87

export PAITON_TARGET_DIR="$PWD/model-cache/qwen38-nvfp4"
export PAITON_DRAFT_DIR="$PWD/model-cache/qwen38-dflash2"
export PAITON_W3ROT_DIR="$PWD/model-cache/qwen38-w3rot-int3"
export PAITON_CACHE_DIR="$PWD/runtime-cache/qwen38-rocm10-20260928"
mkdir -p "$PAITON_TARGET_DIR" "$PAITON_DRAFT_DIR" "$PAITON_W3ROT_DIR" "$PAITON_CACHE_DIR"

hf download unsloth/Qwen3.8-27B-NVFP4 \
  --revision f0b7c9e722f5565102fff8481c99e4d86ae099c7 --local-dir "$PAITON_TARGET_DIR"
hf download tcclaviger/Qwen3.8-27B-DFlash2-FP8 \
  --revision ee0cb26a8279b7910cc28d82a8a3e15e4728d56f --local-dir "$PAITON_DRAFT_DIR"
hf download EliovpAI/Qwen3.8-27B-W3Rot-INT3-Paiton-RDNA4 \
  --revision d74ae7d5f5f1b4b45dd12fb1271e3664283a2ec1 --local-dir "$PAITON_W3ROT_DIR"
(cd "$PAITON_W3ROT_DIR" && sha256sum -c SHA256SUMS)

bash models/Qwen3.8-MXFP4-DFlash2/run-rocm10.sh
De huidige gecombineerde image die deze launcher selecteert, is ghcr.io/eliovp/paiton-vllm-plugin:qwen38-rocm10-vllm029-20260929-r2. De onveranderlijke digest is:
sha256:1195f31329966b3dc4e8e2d17327d339827b3d2b09165f9969b053a6fc2db045
Als PAITON_W3ROT_DIR is ingesteld, selecteert de launcher de geroteerde 3-bit gewichten en in de 65K-modus de 4-bit cache. Zonder die variabele draait hij MXFP4. Stop de eerste server voordat u een andere modus kiest of MXFP4 selecteert met:
bash models/Qwen3.8-MXFP4-DFlash2/run-rocm10.sh --weights mxfp4
Voor één lang gesprek start u dezelfde launcher in plaats daarvan met --context 200000; voor beeldinvoer in de 65K-modus gebruikt u --vision. Draai slechts één modus tegelijk op de GPU. Voeg --kv-cache fp8 aan het 65K-commando toe om het oorspronkelijke FP8-cacheprofiel met W3A4 te herstellen. Zodra de server klaar is, biedt hij de OpenAI-compatibele API op http://127.0.0.1:18982/v1 aan met de modelnaam Qwen3.8. Stuur in een tweede terminal een streamingverzoek:
curl --fail http://127.0.0.1:18982/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3.8","messages":[{"role":"user","content":"Write a short Python function that removes duplicates while keeping their original order."}],"temperature":0,"max_tokens":256,"stream":true,"chat_template_kwargs":{"enable_thinking":false}}'
Deze commando's starten het modelspecifieke W3A4-Dockerprofiel met DFlash2. De kortere native preset paiton serve qwen38-nvfp4 is een andere configuratie zonder speculatieve decode en laadt deze 3-bit gewichten niet.2
Wat volgt
De 4-bit cache levert nu bruikbare extra capaciteit in de gekwalificeerde 65K-modus met W3A4. Hij verandert het 200K-profiel met één verzoek niet en bewijst geen ondersteuning voor het volledige 262K-venster. Het volledige modelvenster en een adaptief langer speculatief blok blijven onderzoekspistes, geen gepubliceerde instellingen van deze release.2
Credits en licenties
Qwen3.8 27B is van het Qwen-team. Het vastgelegde targetcheckpoint komt van Unsloth en de DFlash2-drafter van tcclaviger, voortbouwend op het DFlash2-werk van z-lab. De uitgebrachte geroteerde gewichten zijn een gekwantiseerde afgeleide onder Apache-2.0. De modelkaart vermeldt ook Apache-2.0 voor die upstreamcheckpoints. De openbare methode bouwt voort op GPTQ en GSQ. vLLM biedt de serverbasis en BetterBench de generatietaken. De openbare runtimehandleiding vermeldt Radiance en StillDeadcode/libr4d voor aangepaste kerneltechnieken.12
Voor de openbare adapter, modelgewichten en verpakte native runtime gelden afzonderlijke voorwaarden. De Apache-2.0-licentie van de gewichten is geen algemene licentie voor propriëtaire compiler- of implementatiecode. Kalibratiedatasets behouden ook hun bronvermeldingsvereisten en, waar van toepassing, de Common Crawl-voorwaarden. Bekijk de gepubliceerde vermeldingen vóór inzet.
Ontdek Paiton, lees de vorige Qwen3.8-releasestory, volg de discussie en praktijkmeldingen van gebruikers of neem contact op om een lokale AMD AI-werklast te bespreken.