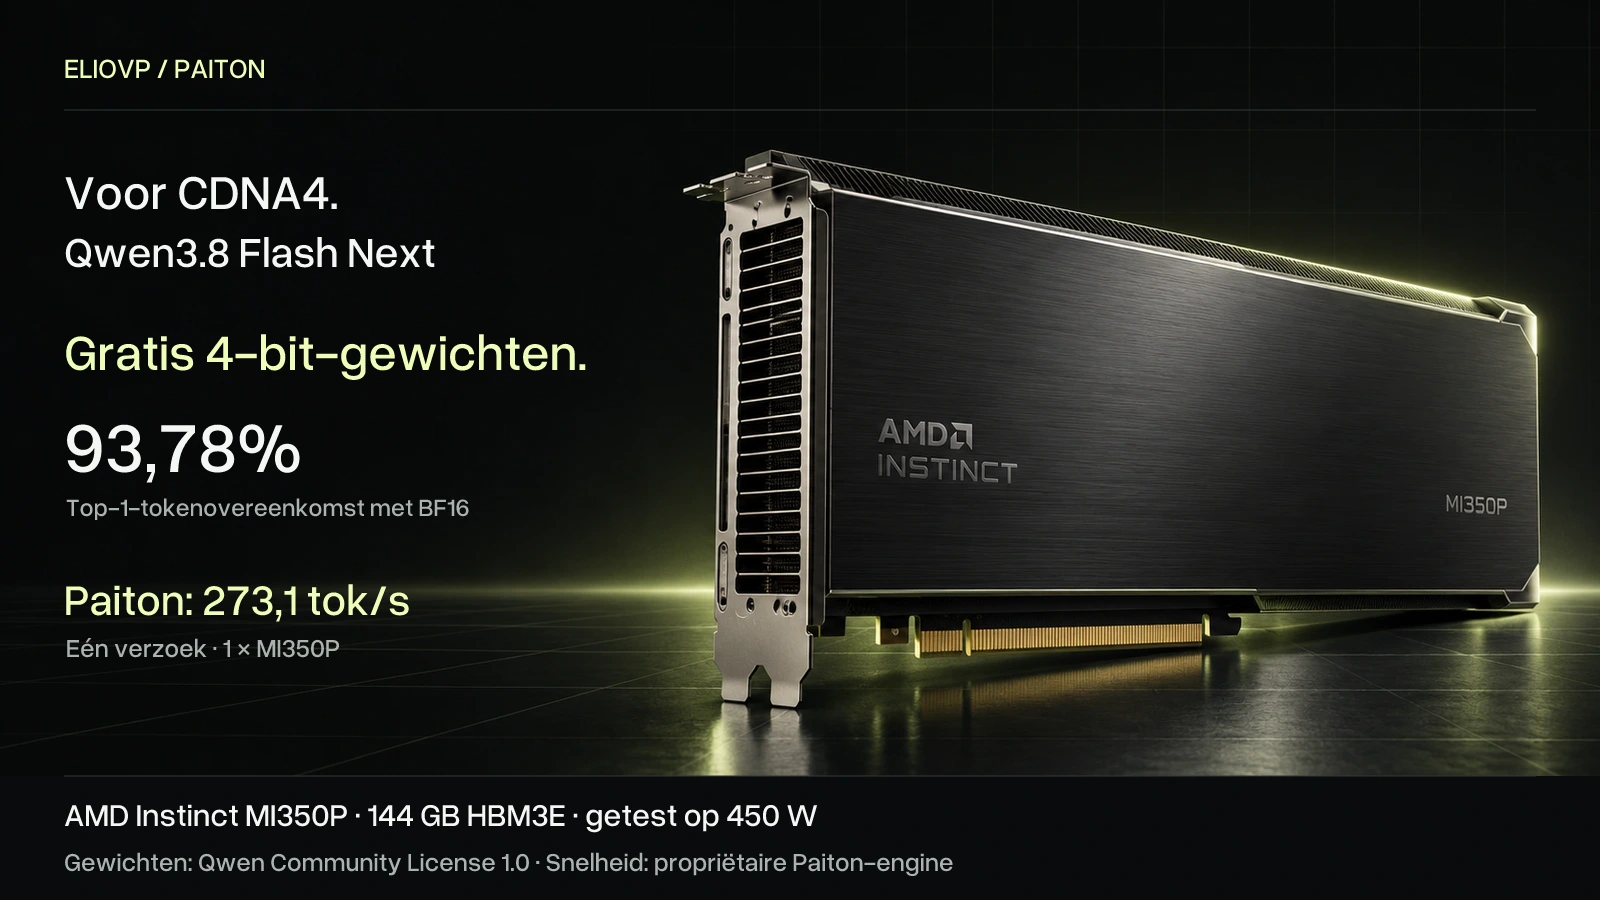
Op één AMD Instinct MI350P met CDNA4 genereert Paiton tekst aan 273,1 tokens per seconde, tegenover 122,1 met onze geteste standaard-vLLM-configuratie met AITER. Dat is 2,24× de snelheid bij één verzoek. Bij 64 gelijktijdige verzoeken stijgt de totale uitvoer naar 2.508,6 tokens/s.
Ook voor gespreksgeschiedenis is er meer ruimte: circa 2,2 miljoen tokens aan GPU-KV-cachecapaciteit, 22% meer dan de geteste vLLM-configuratie. Die capaciteit wordt over verzoeken gedeeld; het is geen contextvenster van 2,2 miljoen tokens voor één gesprek.
De winst is praktisch: minder wachten terwijl tekst verschijnt en meer uitvoer uit dezelfde GPU. De hoofdvergelijking meet tekstgeneratie vanuit een lege context, niet de volledige tijd van prompt tot antwoord. Ze vergelijkt onze A5-gewichten met Paitons native CDNA4-runtime tegenover AMD Quark MXFP4 op vLLM. Het is dus een vergelijking van volledige configuraties, niet alleen van engines.
Onze 4-bit kwantisatie blijft daarbij dicht bij het oorspronkelijke model: 93,78% overeenkomst met het waarschijnlijkste volgende token van BF16 in de afzonderlijke evaluatie van de gewichten. Dat meet overeenkomst tussen voorspellingen, niet het percentage correcte antwoorden. De gewichten en het kwantisatierecept zijn beschikbaar onder de Qwen Community License 1.0.
Dit zijn resultaten van Paiton, ons framework voor AI-optimalisatie, met zijn native CDNA4-runtime. De kwantisatie is bedoeld voor de CDNA4-familie, waaronder MI350P, MI350X en MI355X, met een compatibele runtime en voldoende GPU- en hostgeheugen. De metingen hieronder komen uitsluitend van één MI350P. Het A5-formaat vereist momenteel de propriëtaire Paiton-runtime, die niet met de gewichten wordt verspreid; standaard-vLLM, Transformers en llama.cpp kunnen het niet rechtstreeks laden.
Wat Paiton op één MI350P haalt
Met de A5-gewichten en Paitons native CDNA4-runtime genereert één AMD Instinct MI350P met 144 GB en een vermogenslimiet van 450 W in LocalMaxxing 273,1 tokens/s voor één verzoek. Dat is 2,24× onze geteste standaard-vLLM-configuratie met AITER en AMD's MXFP4-checkpoint. Bij 64 gelijktijdige verzoeken stijgt de totale decode naar 2.508,6 tokens/s, met 2,19 miljoen KV-cachetokens beschikbaar op de GPU.
Dit zijn onze eigen metingen, geen onafhankelijke certificering. We vergelijken volledige configuraties: Paitons A5-gewichten en native runtime tegenover AMD Quark MXFP4-gewichten op vLLM of SGLang. Gewichten en uitvoeringspaden verschillen. Dit is dus geen geïsoleerde vergelijking van engines of de snelheid die je krijgt door alleen onze kwantisatie te downloaden.
De afzonderlijke servingtest voegt 1.024 invoertokens toe, gevolgd door precies 1.024 uitvoertokens. Met één verzoek begint Paiton na mediaan 98 milliseconden te antwoorden. Bij 16 gelijktijdige verzoeken wordt dat 525 ms, tegenover 1.782 ms voor de geteste standaard-vLLM-configuratie. Bij 64 is Paitons mediaan 861 ms, tegenover 2.811 ms.
| Gelijktijdige verzoeken | Totale Paiton-uitvoer, tok/s | Decode per verzoek, tok/s | Eerste token, mediaan / steekproef-p99 |
|---|---|---|---|
| 1 | 331 | 337,6 | 98 / 101 ms |
| 4 | 746 | 193,8 | 150 / 332 ms |
| 16 | 1.046 | 67,6 | 525 / 1.300 ms |
| 32 | 1.444 | 46,4 | 632 / 2.572 ms |
| 64 | 1.790 | 28,9 | 861 / 5.530 ms |
Servingtest met 1K invoer / 1K uitvoer. Decode per verzoek is het omgekeerde van de mediane tijd per uitvoertoken na het eerste token, niet de totale doorvoer gedeeld door gelijktijdigheid. Steekproef-p99 beschrijft deze gemeten verzoeken, geen productiegarantie. Grafiekgegevens.
Bij meer belasting komt elk antwoord langzamer binnen, maar produceert de kaart in totaal meer. De snelheid per verzoek bepaalt hoe snel een assistent antwoordt; de totale uitvoer bepaalt hoeveel verzoeken de hardware kunnen delen.
Dit zijn verzoeken met vaste lengtes en vensters uit brontekst, geen proef met 64 mensen die chatten. Echt verkeer heeft wisselende prompts, pauzes, toolaanroepen en aankomstmomenten. De tabel is een gemeten vertrekpunt voor capaciteitsplanning, geen vervanging voor tests met dat verkeer.
Een rekenvoorbeeld voor 1.000 gelijktijdig actieve gebruikers
Stel dat het doel minstens 20 Engelse woorden/s mediane decode en een steekproef-p99 voor het eerste token binnen 10 seconden is. Met ongeveer 0,75 woorden/token geeft het hoogste geteste 1K / 1K-niveau dat beide drempels haalt:
| Configuratie | Verzoeken per kaart volgens deze regel | Kaarten voor 1.000 |
|---|---|---|
| Paiton | 64 | 16 |
| vLLM + AITER | 32 | 32 |
| SGLang MTP, 16 plaatsen | 16 | 63 |
Dit is rekenwerk uit een korte synthetische test, geen gemeten implementatie met 1.000 gebruikers of capaciteitsgarantie. Reserves voor pieken, hoge beschikbaarheid en volledige systeemkosten ontbreken. De omrekening naar Engelse woorden is een benadering, geen eigenschap van elke prompt of taal.
Hoeveel van het oorspronkelijke model behoudt A5?
We controleerden de gekwantiseerde gewichten tegenover het oorspronkelijke BF16-checkpoint, met een emulatie van de berekeningen tijdens serving. De vastgezette modelkaart bevat de volledige methode en resultaten.
Afzonderlijke evaluatie van de gewichten tegenover BF16. Lagere KL over de volledige woordenschat ligt dichter bij de referentie; top-1 meet tokenovereenkomst, geen taaknauwkeurigheid. De INT4-g128-vergelijking gebruikt ons RDNA4-recept in hetzelfde evaluatieprogramma. Dit staat los van de enginecontrole met 130 posities verderop.
| Controle van de gewichten | A5-resultaat |
|---|---|
| Hetzelfde waarschijnlijkste volgende token als BF16 | 93,78% |
| KL-divergentie over de volledige woordenschat, lager is dichterbij | 0,0265 |
| 95%-interval voor KL | 0,0239 tot 0,0292 |
Deze scores betreffen tekst- en assistentposities uit een afzonderlijke evaluatieset van 294.912 tokens. Overeenkomst betekent dat beide modellen op die positie hetzelfde volgende token kiezen. Het betekent niet dat 93,78% van de antwoorden correct is. KL vergelijkt de volledige kansverdelingen voor het volgende token; nul betekent identiek. Twee correcte BF16-implementaties scoren met deze methode ongeveer 0,008.
Bij langere context blijft de negatieve log-likelihood binnen +0,2% van BF16 in de documentcategorieën van 8K tot 32K. Terugvindtests reproduceren de referentieantwoorden bij 8 van 8 prompts van 131K en 4 van 4 prompts van 258K. Een vervolg na een gebruikersbeurt van 254K tokens heeft een 1,9% hogere negatieve log-likelihood dan BF16.
Dit zijn controles van gewichten en informatie terugvinden, geen bewijs voor productieserving bij die lengtes. Wiskunde, code, kennis, meertaligheid en kwaliteit van toolaanroepen zijn voor deze release niet als taken gebenchmarkt.
Wat is Paiton?
Paiton is ElioVP's framework om AI-modellen efficiënter op AMD-GPU's te laten draaien. Het combineert modelcompilatie, kernels afgestemd op de hardware, runtime-optimalisatie en integratie met servingsoftware zoals vLLM. De native runtime in deze benchmark is daar één onderdeel van, niet het hele product.
AMD beschreef deze aanpak al in Introduction to Paiton by ElioVP, gepubliceerd in oktober 2025. Onze Paiton-productpagina bevat het huidige overzicht, met toepassingen voor taalmodellen, beeld- en videogeneratie.
Wat we voor deze CDNA4-release veranderden
De release combineert onze kwantisatie, native CDNA4-kernels en een vLLM-server.
Ten eerste onze eigen A5-kwantisatie van Qwen3.8-Flash-Next. De gerouteerde experts, die het grootste deel van de modelgewichten bevatten, gebruiken native FP4-codes met één schaalfactor per 128 gewichten. De belangrijkste gewichten buiten de experts gebruiken 8-bit formaten. Het recept gebruikt ongeveer vier miljoen kalibratietokens en staat in de publieke modelkaart.
Ten tweede Paitons native CDNA4-runtime. Die voert de modelberekening en sampling uit met kernels voor deze hardware, inclusief samengevoegde bewerkingen voor decode, prefill en experts. Asynchrone planning laat voorbereiding op de host overlappen met uitvoering op de GPU.
Ten derde de reguliere vLLM-serverinterface. De Paiton-plugin verbindt de runtime met de OpenAI-compatibele server van vLLM. Bestaande clients kunnen die API blijven gebruiken.
Speculatieve generatie helpt bij lage gelijktijdigheid. Een fijnafgestemde MTP-drafter stelt drie tokens voor, die het hoofdmodel samen controleert. Boven vier actieve verzoeken schakelt deze release de drafter uit: de controle kost dan meer dan ze bespaart. Die afweging is zichtbaar in de resultaten hieronder.
“Eén GPU” betekent niet dat elke tensor in GPU-geheugen staat. Ongeveer 48 GiB aan n-gram-embeddings staat in het werkgeheugen van de host. Tijdens de uitvoering worden de benodigde rijen opgehaald. Samen met de kleinere expertgewichten laat dat meer GPU-geheugen vrij voor actieve verzoeken.
Snellere decode over het hele geteste bereik
De lmx-snelheidstest van LocalMaxxing meet generatie vanuit een lege context, los van het verwerken van de prompt. Paiton loopt in deze benchmark voor op elk getest niveau, van één tot 64 gelijktijdige verzoeken.
Totale uitvoertokens/s; hoger is beter. Eén MI350P met een ingestelde limiet van 450 W. Paiton gebruikt A5, de andere configuraties AMD Quark MXFP4. Resultaten en herkomst.
| Gelijktijdige verzoeken | Paiton | vLLM + AITER | SGLang MTP, 8 plaatsen | SGLang MTP, 16 plaatsen | SGLang zonder MTP |
|---|---|---|---|---|---|
| 1 | 273,1 | 122,1 | 118,6 | 119,6 | Niet getest |
| 2 | 453,4 | 195,4 | 223,1 | 219,0 | Niet getest |
| 4 | 676,5 | 384,7 | 397,0 | 403,5 | Niet getest |
| 8 | 839,6 | 602,8 | 639,2 | 629,9 | Niet getest |
| 16 | 1.265,8 | 1.029,0 | 634,4 | 829,3 | Niet getest |
| 32 | 1.886,7 | 1.544,1 | Niet gemeten | Niet gemeten | 1.088,6 |
| 64 | 2.508,6 | 2.185,2 | Niet gemeten | Niet gemeten | 1.093,0 |
SGLang gebruikt versie 0.5.22 met AITER; vLLM versie 0.32.0 met AITER. De SGLang-MTP-profielen boden in onze opstelling geen ruimte voor een configuratie met minstens 32 actieve verzoeken. Die metingen gebruiken daarom een afzonderlijk benoemd profiel zonder MTP. Het gaat om geteste configuraties, niet om universele grenzen van deze engines.
Bij één verzoek is de voorsprong op het snelste alternatief 2,24×. Bij 16 is die 23%; bij 64 15%. De winst neemt af wanneer batching de referentie efficiënter maakt, maar blijft aanwezig over de hele matrix.
Eerder klaar met een lange prompt
Prefill is het werk vóór de generatie: de invoer lezen en de benodigde toestand opbouwen. Hier is Paiton bijna twee keer zo snel als de geselecteerde standaard-vLLM-referentie. SGLang komt veel dichterbij, vooral bij de langere prompt.
Invoertokens/s voor één prompt met nominale dieptes van 8K en 64K; hoger is beter. De werkelijke lengtes na tokenisatie zijn ongeveer 8.200 en 64.100 tokens. Dit staat los van decodedoorvoer.
| Configuratie | Prefill 8K, tok/s | Prefill 64K, tok/s |
|---|---|---|
| Paiton | 13.709 | 14.286 |
| SGLang MTP, 8 plaatsen | 12.069 | 11.585 |
| SGLang MTP, 16 plaatsen | 11.535 | 13.827 |
| SGLang zonder MTP | 12.184 | 13.401 |
| vLLM + AITER | 7.009 | 7.224 |
Voor de prompt van ongeveer 64K tokens is de gemeten tijd tot het eerste token 4,49 seconden met Paiton, 4,64 seconden met SGLang MTP16 en 8,88 seconden met vLLM. Tegenover het beste alternatief is de prefillwinst 13% bij 8K en 3% bij 64K. De grotere winst van ongeveer 2× geldt specifiek tegenover de geselecteerde vLLM-referentie.
Circa 2,2 miljoen KV-cachetokens op één GPU
De KV-cache is werkgeheugen voor de tokens die een model verwerkt. Meer capaciteit kan ruimte bieden voor langere of meer verzoeken, afhankelijk van de overige geheugenvereisten en planning van de engine.
Door de runtime gerapporteerde GPU-KV-cachecapaciteit, geen extra fysiek geheugen of gemeten aantal gelijktijdige lange gesprekken.
| Configuratie | KV-cachetokens | Blokken van 32K, alleen geheugenschatting |
|---|---|---|
| Paiton | 2.190.540 | 66 |
| vLLM + AITER | 1.795.019 | 54 |
| SGLang MTP, 8 plaatsen | 367.424 | 11 |
| SGLang MTP, 16 plaatsen | 64.704 | 1 |
Paiton rapporteert 22% meer tokencapaciteit dan vLLM en ongeveer 6× de standaard-SGLang-MTP-configuratie met acht plaatsen. SGLang reserveert bij een hogere limiet voor actieve verzoeken meer toestand per verzoek, waardoor minder ruimte overblijft voor de KV-cache.
Hier betekent 32K precies 32.768 tokens. De laatste kolom deelt de capaciteit door dat aantal en rondt naar beneden af. Dat bewijst niet dat 66 gesprekken tegelijk kunnen draaien: Paiton is ingesteld op 64 actieve sequenties, gegenereerde tokens hebben ook ruimte nodig en andere toestand per verzoek telt mee. We hebben geen 64 gelijktijdige prompts van 32K getest.
Alle configuraties hadden een ingestelde contextlimiet van 262.144 tokens. Zo'n instelling bewijst niet dat elke configuratie een verzoek van die grootte kan verwerken. De cache van SGLang MTP met 16 plaatsen is bijvoorbeeld kleiner dan die limiet.
Belasting verandert het resultaat
De servingtest voegt invoerverwerking en langere antwoorden toe. We testten drie vormen: 1K / 1K, 1K / 8K en 8K / 1K invoer-/uitvoertokens, met één tot 64 gelijktijdige verzoeken. K betekent hier 1.024 tokens.
Totale uitvoer tegenover decode per verzoek in de servingtest. Dit zijn andere metingen dan LocalMaxxing. Volledige gegevens over latentie, doorvoer en vermogen staan in de downloads.
Voor één verzoek met een antwoord van 8K tokens is Paitons mediane voltooiingstijd 22,6 seconden, tegenover 43,1 seconden voor SGLang en 67,0 seconden voor vLLM. Bij 64 gelijktijdige verzoeken met die vorm is de totale uitvoer 1.937 tok/s, tegenover 1.737 tok/s voor vLLM.
Lange invoer zet meer druk op de planning. Bij 64 verzoeken met 8K invoer / 1K uitvoer stijgt Paitons mediane tijd tot het eerste token naar 9,6 seconden. Dat is korter dan vLLM's 37,6 seconden, maar nog steeds een flinke wachttijd. Een hoge totaalscore laat die latentie niet verdwijnen.
Energie: meer uitvoer per GPU-watt
Een vermogenslimiet is geen gemeten verbruik. Tijdens de 1K / 1K-test stijgt Paitons gemiddelde GPU-meting van ongeveer 308 W bij één verzoek naar 445 W bij 64. Gecombineerd met de doorvoer geeft dat de volgende efficiëntie.
Uitvoertokens/s per kW gemeten GPU-vermogen; hoger is beter. Exclusief CPU, systeemgeheugen, verliezen in de voeding en koeling.
| Configuratie | 1 verzoek | 16 verzoeken | 64 verzoeken |
|---|---|---|---|
| Paiton | 1.076 | 2.577 | 4.021 |
| vLLM + AITER | 413 | 2.120 | 3.354 |
| SGLang MTP, 16 plaatsen | 645 | 2.720 | Niet gemeten |
| SGLang zonder MTP | Niet gemeten | Niet gemeten | 2.493 |
Paiton levert bij één verzoek 2,60× zoveel uitvoer per eenheid GPU-energie als de vLLM-referentie en bij 64 verzoeken 20% meer. SGLangs profiel met 16 plaatsen is bij 16 verzoeken 5,6% efficiënter dan Paiton. Die uitzondering is relevant wanneer je een gewenste bedrijfsbelasting kiest.
Dit zijn uitsluitend GPU-cijfers uit AMD SMI, geen metingen aan het stopcontact of berekening van de volledige serverkosten. Hostenergie is hier extra relevant omdat een deel van het model in systeemgeheugen staat.
Een afzonderlijke nauwkeurigheidscontrole van de engines
De evaluatie aan het begin van dit artikel test de kwantisatie. Daarnaast controleerden we de uitvoeringspaden: voorspellingen op 130 tokenposities na prompts van 8.128 tokens, met de referentietokens als voorafgaande invoer. Deze controle gebruikt een andere maat: de 1.024 hoogst gewaardeerde referentietokens plus de resterende kansmassa als één restterm.
Beperkte diagnostiek van het volgende token, geen antwoordnauwkeurigheid. Lagere KL ligt dichter bij BF16. Paiton en AMD MXFP4 draaien op MI350P; de BF16-controle op MI355X. De meetpaden verschillen.
| Configuratie | KL-divergentie | Overeenkomst waarschijnlijkste token |
|---|---|---|
| BF16-controle via vLLM, MI355X | 0,0077 | 95,4% |
| Paiton A5-testpad van de engine, MI350P | 0,0219 | 93,1% |
| AMD Quark MXFP4 via vLLM + AITER, MI350P | 0,1141 | 80,8% |
Paiton ligt in deze kleine steekproef dichter bij de referentie. Dat betekent niet dat 93,1% van de antwoorden correct is of dat één configuratie vijf keer nauwkeuriger is op gebruikerstaken.
Paiton wordt gemeten via het testpad van de engine met MTP uit; de andere rijen via een vLLM-API-client. Rijen met korte prompts zijn uitgesloten omdat de BF16-controle daar inconsistenties liet zien. De vergelijking combineert ook verschillen in checkpoints en kernels. De gepubliceerde logs onderbouwen deze geselecteerde rijen, maar de bundel bevat niet de volledige referentieverdelingen of evaluatieclient om deze controle onafhankelijk opnieuw uit te voeren.
Van RDNA4 op Radeon naar CDNA4 op Instinct
Dit werk staat niet los van onze Radeon-releases. Met 3-bit Qwen3.8 27B op één Radeon AI PRO R9700 haalde Paiton 492,1 uitvoertokens/s over acht gelijktijdige verzoeken en 19,9% snellere gewogen decode dan de voorgaande MXFP4-release. Het artikel bevat de instellingen en nauwkeurigheidsafwegingen van die vergelijking.
Onze latere Flash Next-update op twee R9700's verbeterde de 3-bit nauwkeurigheid en voegde prefix caching met MTP toe. De optionele native worker haalde 258,7 tokens/s gewogen decode bij één verzoek. In een afzonderlijke test daalde de tijd tot het eerste token bij een herhaalde conversatie van 200K tokens van 25,81 seconden zonder cachetreffer naar 0,68 seconden met cachetreffer. Het ongewijzigde begin van de conversatie moet daarvoor nog in de cache staan.
De 27B W3Rot-gewichten en Flash Next W3A8-gewichten telden samen meer dan 2.200 Hugging Face-downloads in de voorafgaande 30 dagen, gecontroleerd op 30 oktober 2026. Dat telt downloads, geen unieke gebruikers.
Hetzelfde doel loopt door deze releases: meer halen uit AMD-hardware door model en uitvoering samen te optimaliseren. De R9700- en MI350P-cijfers komen uit afzonderlijke tests met verschillende modellen en instellingen; dit is geen rechtstreekse vergelijking tussen de kaarten.
Een blik op de benchmarkuitvoer
Laatste beeld uit de oorspronkelijke terminalopname, zonder wijzigingen. Klik om te vergroten. Deze afzonderlijke run gebruikt meetcellen van twintig seconden, niet de dertig seconden van de hoofdbenchmark. De bronopname en timinglogs zitten in de download met nauwkeurigheids- en opnamegegevens.
Bekijk de meetgegevens
De onderbouwing is opgesplitst in overzichtelijke downloads met ruwe matrices, records per verzoek, opdrachten en checksums. De 177 vermeldingen in het aangeleverde SHA-256-manifest zijn vóór publicatie succesvol gecontroleerd. Dat controleert bestandsintegriteit, geen onafhankelijke geldigheid van het experiment.
Waarom deze resultaten niet op LocalMaxxing staan: we zouden de cijfers daar ook graag publiceren, maar de GPU-detectie herkende de MI350P in deze run niet. Daardoor konden we de resultaten er niet publiceren. Het label CPU_ONLY in het rapport is een detectiebeperking, geen beschrijving van de uitvoering: het model draaide op de MI350P. We delen de ruwe resultaten hier, zodat lezers ze zelf kunnen bekijken.
- Paiton-benchmarkgegevens
- vLLM-benchmarkgegevens
- SGLang-benchmarkgegevens
- Nauwkeurigheidslogs en onderbouwing van de terminalopname
- Methoden, opdrachten, servingclient en checksummanifest
- Grafiekgegevens en geselecteerde bronpaden
Download de standaardreferentiecontainer
De publieke CDNA4-container bevat standaard-vLLM 0.32 met AITER, ingesteld om AMD's Quark MXFP4-checkpoint te serveren. Download de gepubliceerde image via de digest:
docker pull ghcr.io/eliovp/paiton-vllm-plugin@sha256:20b729e6c7b0f2de101fd27d080d91291a7d37c4002312fe9ee5aeb5ff131b19
Dit downloadt de referentiecontainer; het start geen server en levert de propriëtaire engine niet mee. De methodendownload bevat de oorspronkelijke benchmarkopdrachten. Deze image kan de A5-gewichten niet serveren en reproduceert de Paiton-kolom niet.
Meetinstellingen
SGLang-profielen. De servingtest gebruikt MTP met 16 plaatsen voor 1K / 1K en acht plaatsen voor de langere vormen, gekozen op basis van de hoogste piekdoorvoer per vorm. Bij 32 en 64 verzoeken is de configuratie zonder MTP gebruikt.
Gelijke omstandigheden. Eén MI350P, een ingestelde GPU-limiet van 450 W, ventilatoren op volle snelheid, één benchmark tegelijk en de client op de serverhost.
LocalMaxxing. lmx 0.1.54 met llm-inference-bench 0.7.7, meetcellen van dertig seconden, decode vanuit een lege context met maximaal 8.192 uitvoertokens en nominale 8K/64K-prefill. Na opwarmen draaien de hoofdconfiguraties drie matrices; we kiezen de volledige run met de middelste decodescore bij één verzoek. De c32/c64-metingen van de referenties zijn afzonderlijke enkelvoudige runs, geen medianen uit drie runs.
Servingtest. Een streamingclient gebruikt greedy generatie, negeert EOS en geeft elk verzoek een eigen venster uit brontekst. Na twee opwarmrondes met korte uitvoer start hij maximaal max(8, 2 × gelijktijdigheid) verzoeken. Na honderd seconden worden geen nieuwe verzoeken gestart; lopende verzoeken worden afgemaakt. De meetcellen bevatten 2 tot 128 gemeten verzoeken, allemaal zonder fouten of te korte uitvoer. Bij kleine steekproeven ligt p99 dicht bij het waargenomen maximum; het is geen betrouwbaar populatiepercentiel.
Selectiedetail. Het getoonde vLLM-resultaat bij 1K / 1K en c32 gebruikt de eerdere meetcel van 1.169,2 tok/s. Een latere herhaling gaf 1.064,0 tok/s. Beide staan in de download. Andere c32/c64-rijen uit de servingtest gebruiken de latere reeks. De bronpaden in de grafiekgegevens maken die keuze expliciet.
De MI350P-resultaten tonen wat het Paiton-framework op deze CDNA4-configuratie levert: de grootste snelheidswinst ligt bij lage gelijktijdigheid, met aanhoudende winst onder zwaardere belasting. Onze volgende optimalisatie is speculatieve generatie rendabel maken boven vier actieve verzoeken.
Lees de publieke gewichten en het kwantisatierecept of ontdek Paiton.
Omslag: met AI gemaakte redactionele illustratie van een MI350P, geen productfoto of benchmarkopname.
Een token factory? Haal meer uit je AMD-GPU's.
Heb je al een token factory of wil je er één starten? We helpen je de doorvoer te verhogen, de kosten per token te verlagen en meer rendement uit je AMD-hardware te halen.