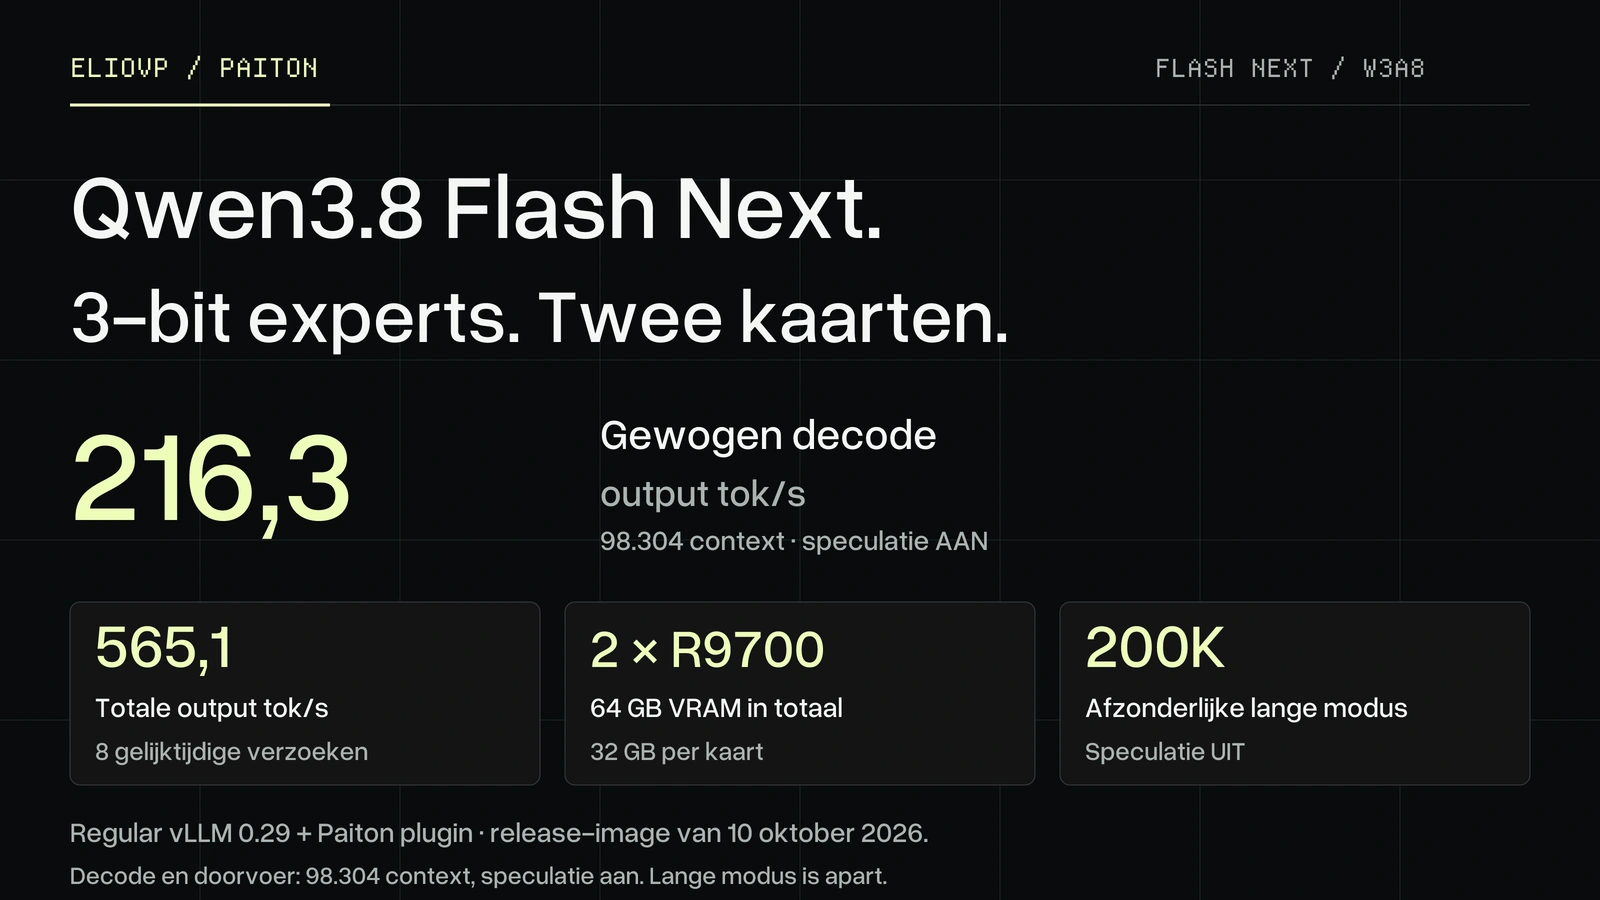
Een lokale assistent moet vlot kunnen schrijven, lange documenten kunnen verwerken en meer dan één gebruiker kunnen bedienen. Onze nieuwste Paiton-release brengt Qwen3.8 Flash Next naar twee Radeon AI PRO R9700-kaarten, met 216,3 tokens per seconde als gerapporteerde gewogen decodescore, 565,1 tokens per seconde voor acht gelijktijdige verzoeken samen en een aparte contextmodus van 200.000 tokens.1
De hardware bestaat uit twee kaarten met elk 32 GB VRAM. De grote gerouteerde experts gebruiken 3-bit gewichten; gevoeligere onderdelen behouden een hogere precisie. Het model draait via reguliere vLLM 0.29, de Paiton-plugin en native AMD-kernels, niet via een afzonderlijke serving-engine.23
Daar horen belangrijke kanttekeningen bij. De 200K-modus genereert ongeveer 100 tokens/s in plaats van de circa 200 van de standaardmodus, omdat speculatieve decode uitstaat. Een grote n-gram-embeddingtabel blijft in het systeemgeheugen. De kwaliteitscontrole meet overeenkomst met het BF16-model en afgebakende lang-contextopzoektests, geen brede benchmarks voor rekenen, code, kennis, meertaligheid of toolgebruik. Hieronder staat wat we hebben gemeten, wat de cijfers betekenen en hoe je het zelf probeert.
Vlotte generatie op twee workstationkaarten
Decode meet de generatie na het eerste token. In de validatierun van de release-image op 10 oktober gaf het standaardprofiel van BetterBench 0.6.0 een gewogen score van 216,3 tokens/s. De afzonderlijke taken varieerden van 183,3 voor proza tot 259,2 voor JSON.1
Validatie van de release-image, twee R9700-kaarten, 98.304 tokens ingestelde context en speculatieve decode aan. Gegenereerde tokens/s; hoger is beter. De gewogen score is geen gemiddelde met gelijke gewichten voor de acht rijen; de taakgewichten staan verderop. Dit zijn metingen van dit model en deze configuratie, geen vergelijking met onze eerdere 27B-releases.
| Taak | Gegenereerde tokens/s |
|---|---|
| Chat | 202,1 |
| Code | 214,3 |
| Bestandsbewerking | 236,0 |
| JSON | 259,2 |
| Rekenen | 255,5 |
| Proza | 183,3 |
| Redeneren | 190,1 |
| Samenvatten | 239,8 |
| Gerapporteerde gewogen score | 216,3 |
De mediane wachttijd tot het eerste token was 117 ms voor korte prompts. De p99 van streamupdates was 13,9 ms, maar dat is de tijd tussen updates, niet de vertraging per token: speculatieve decode kan meerdere geaccepteerde tokens in één update afleveren.1
Meer uitvoer wanneer verzoeken overlappen
Totale generatiedoorvoer voor gelijktijdige verzoeken; hoger is beter. BetterBench voerde 48 verzoeken uit per gelijktijdigheidsniveau. Dit zijn gezamenlijke serversnelheden, niet de snelheid die elke gebruiker afzonderlijk krijgt. De meting met één verzoek gebruikt een andere taak dan de gewogen decodescore hierboven.
| Gelijktijdige verzoeken | Totale tokens/s |
|---|---|
| 1 | 204,6 |
| 2 | 315,1 |
| 4 | 449,2 |
| 8 | 565,1 |
Bij acht gelijktijdige verzoeken voltooiden alle 48 van de 48 verzoeken. Dat is nuttig voor een gedeelde lokale assistent, maar acht overlappende benchmarkverzoeken betekenen niet dat acht volledige gesprekken van 98K tegelijk passen. Prompts, gegenereerde uitvoer en de toestand per verzoek gebruiken allemaal het beschikbare geheugen.1
Lange prompts zonder sterke daling van de doorvoer
Prefill is het verwerken van de invoer vóór de generatie begint. De aparte lang-contextmodus, met speculatieve decode uit, verwerkte de geteste promptdieptes met ongeveer 7.900 tot 8.300 tokens/s.1
Verwerkte invoertokens per seconde; hoger is beter. BetterBench-standaardprofiel met een uitgebreide 128K-meting, twee R9700-kaarten, 200.000 tokens ingestelde context, speculatieve decode uit en prefillblokken van 2.048 tokens. De dieptelabels zijn nominale instellingen, geen exacte promptlengtes. Deze resultaten komen uit de lange modus, niet uit de speculatieve decodeconfiguratie.
| BetterBench-instelling voor promptdiepte | Invoertokens/s |
|---|---|
| 2K | 7.925 |
| 8K | 8.321 |
| 16K | 8.311 |
| 32K | 8.232 |
| 64K | 8.161 |
| 128K | 7.928 |
Het 128K-resultaat blijft dicht bij dat van 8K. Een aparte proef met koude cache en precies 64.000 prompttokens mat 8.212 tokens/s over de volledige prompt, of 8.204 in stabiele toestand na het eerste blok. Promptdoorvoer is niet hetzelfde als de volledige wachttijd op een antwoord: bij een nieuwe 190K-prompt duurde het 24,8 seconden tot het eerste token.1
Kies de modus die bij de taak past
| Modus | Ingesteld contextvenster | Speculatieve decode |
|---|---|---|
decode, standaard | 98.304 tokens | Aan, diepte 3 |
prefill-long | 200.000 tokens | Uit |
Dit zijn totale contextvensters: de prompt, chatopmaak en het gegenereerde antwoord moeten samen passen. Het native checkpointvenster is 262.144 tokens, maar deze release bevestigt dat volledige venster niet op deze twee kaarten.32
De 200K-modus heeft het geheugen nodig dat anders de toestand van de speculatieve drafter per verzoek bevat. Zonder speculatieve decode leverde generatie met één verzoek na prompts van 32K, 100K en 190K respectievelijk 105,3, 100,6 en 99,9 tokens/s, met voortzettingen van 256 tokens. Lange context blijft daarmee bruikbaar, met een andere snelheidsafweging dan de standaardmodus.1
Hergebruik een lange prompt met optionele prefixcaching
Als je herhaaldelijk vragen stelt over hetzelfde document, kan het opnieuw verwerken van de ongewijzigde prefix het grootste deel van de wachttijd innemen. De optionele prefixcache bewaart checkpoints van de attention-cache en recurrente toestand op uitgelijnde grenzen van 2.048 tokens.2
Aparte controles met herhaalde prompts in de lang-contextmodus. Wachttijd tot het eerste token in seconden; lager is beter. Een cachehit hergebruikt een ongewijzigde prefix die nog in de cache staat. Dit zijn niet de BetterBench-metingen met koude cache hierboven.
| Herhaalde prompt | Eerste token met koude cache | Prefixcachehit |
|---|---|---|
| 64K | 9,6 s | 0,35 s |
| 128K | 20 s | 0,41 s |
In deze controles was de uitvoer na een hit byte-identiek aan die van de run zonder cache. Dat is een resultaat voor de geteste verzoeken met en zonder cache, geen belofte van identieke uitvoer bij elke samplinginstelling. Prefixcaching is optioneel en de belangrijkste doorvoerbenchmarks zijn zonder prefixcaching gemeten.1
Wat 3-bit hier betekent
Dit is een model met gemengde precisie, niet de claim dat elke tensor drie bits gebruikt.
De gerouteerde experts, samen goed voor 120,8 miljard gewichten, gebruiken 3,125 bits per gewicht inclusief groepsschalen. Die experts nemen samen ongeveer 47,2 GB in. Een geroteerde invoerbasis helpt de representatie met lage precisie. De native kernels lezen de verpakte gewichten rechtstreeks, zonder eerst het volledige model naar een groter formaat uit te pakken. W3A8 verwijst naar de 3-bit expertgewichten en 8-bit expertactivaties.3
De belangrijkste projecties buiten de experts gebruiken 8-bit gewichten. De speculatieve MTP-laag heeft 4-bit expertgewichten en een 2-bit draftkop; andere tensors behouden hogere precisie. Routers, normalisatie en de behouden vision-tower hebben eveneens eigen precisiekeuzes. De openbare modelkaart vermeldt de tensorformaten. De gevalideerde servermodi zijn alleen voor tekst, ook al bevat de repository de vision-tower.32
De gewichten komen uit onze eigen sequentiële GPTQ-kalibratie op twee miljoen tokens proza, code en assistentgesprekken. We testten twee kalibratiereplicaten en scheidden selectie- en bevestigingsdata. Hun KL-resultaten op de bevestigingsdata, 0,0630 en 0,0686, verschilden genoeg om kleine verschillen tussen kandidaatformaten niet te zwaar te interpreteren.3
Waar het geheugen naartoe gaat
De grote decoder- en expertgewichten blijven op de GPU's, verdeeld over twee tensorparallelle ranks. Elke kaart bevat 24,9 GiB tekstgewichten plus 0,7 GiB voor de MTP-laag. Beide benchmarkconfiguraties piekten op 30,5 tot 31,5 GiB per kaart, inclusief cache, recurrente toestand en uitvoeringsgrafen.3
Er is geen expert-offload, maar dit is geen configuratie die uitsluitend GPU-geheugen gebruikt. De n-gram-tabel van 48,9 GiB blijft vastgezet in het systeemgeheugen, verdeeld over de ranks. De runtime leest er 16 rijen per token uit. De testhost had 251 GiB systeemgeheugen. De checkpointrepository neemt 108 GiB op schijf in, zonder extra ruimte voor de container en runtimecache.32
Kwaliteit: vergelijkbare verdelingen zijn geen taakbenchmarkscores
We onderzochten hoeveel de voorspelde verdeling voor het volgende token over de volledige woordenschat afwijkt van BF16. Bij KL-divergentie is lager beter; nul zou identieke verdelingen betekenen. Top-1-overeenkomst meet hoe vaak beide versies hetzelfde volgende token verkiezen. Het is niet het percentage opgeloste rekenvragen of programmeertaken.3
Tekst- en assistentposities in hetzelfde evaluatiecorpus. Vrije routing laat elk model zijn eigen experts kiezen; vastgezette routing dwingt de BF16-expertkeuze af en scheidt zo rekenfouten van routingwijzigingen. KL en top-1-overeenkomst meten verschillende zaken met verschillende eenheden. De BF16-controle toont variatie tussen twee correcte implementaties.
| Evaluatie | KL tegenover BF16, vrije routing | KL, BF16-routing afgedwongen | Top-1-overeenkomst |
|---|---|---|---|
| BF16 tegenover BF16, implementatieondergrens | 0,0077 | Niet van toepassing | 96,77% |
| Dit 3-bit model | 0,0604 | 0,0413 | 90,74% |
Het corpus bevat 294.912 posities, waaronder 170.884 tekst- en assistentposities voor de hoofdmetingen. Afzonderlijk slaagde de releasecontainer voor zijn served-KL-controle met 0,0616, tegenover een opgegeven budget van 0,0600 plus 0,002. Die controle gebruikt top-64-bucket-KL op de bevestigingshelft en is dus niet dezelfde meting over de volledige woordenschat als de tabel hierboven. Ze valideert de draaiende server, niet alleen een emulatie.34
Lange documenten en afgebakende opzoektests
Een apart gehouden set van 44 documenten van 8K tot 32K tokens, samen 524.288 posities, geeft een afzonderlijk beeld van fouten naarmate het document vordert. Het documentresultaat voor tekst- en assistentposities is 0,0561 KL met vrije routing, 0,0408 met vastgezette routing en 90,39% top-1-overeenkomst.3
| Positie in het document | KL, vrije routing | KL, routing vastgezet | Top-1-overeenkomst voor tekst/assistent |
|---|---|---|---|
| Onder 2K | 0,1554 | 0,1043 | 89,46% |
| 2K–4K | 0,6300 | 0,2931 | 89,66% |
| 4K–8K | 0,6408 | 0,2984 | 90,06% |
| 8K en verder | 0,4333 | 0,2150 | 91,65% |
De KL-waarden per segment hierboven omvatten alle posities; hun top-1-waarden omvatten tekst- en assistentposities. Vergelijk ze daarom niet rechtstreeks met de hoofd-KL voor tekst en assistent. Het laatste segment bevat 12 documenten, de andere segmenten 44.
Op tekst- en assistentposities bedroeg de negatieve log-likelihood op documentniveau 1,7574 nats/token voor BF16 en 1,7671 voor dit model, een gepaard verschil van +0,0097. Dat is een klein gemeten verlies op deze aparte set, geen bewijs van identieke taakkwaliteit.3
| Opzoekcontrole op de draaiende server | Dit model | BF16-controle |
|---|---|---|
| Needle-opzoektest bij 131.072 tokens | 40 / 40 | 40 / 40 |
| Needle-opzoektest bij 200.000 tokens | 40 / 40 | 40 / 40 |
Beide versies gaven in deze tests dezelfde antwoorden. Ook de drafter bleef dichtbij in een teacher-forced greedy-controle op diepte 3: 1,768 verwachte geaccepteerde drafts per stap, tegenover 1,789 voor de BF16-MTP-laag op het BF16-model. Noch de opzoektests, noch de draftacceptatie bevestigen algemene redeneerkwaliteit.3
Rekenen, code, algemene kennis, meertaligheid en toolgebruik kregen voor deze release geen taakbenchmarks. Beeldinvoer is niet gevalideerd. Test de taken waarvoor je het model wilt inzetten; overeenkomst tussen tokenverdelingen vervangt die evaluatie niet.
De runtime, zonder eigen serving-engine
vLLM levert het serverframework en de OpenAI-compatibele API. Paitons native kernels verwerken de verpakte experts, tensorparallelle uitvoering en modelspecifieke bewerkingen. Speculatieve decode stelt drie tokens voor en controleert ze samen. De runtime verwerkt ook de toestand van recurrente lagen wanneer een draft wordt afgewezen. De releaserun accepteerde mediaan 2,85 tokens per streamupdate.23
Een sneller prefillpad, of reproduceerbaar rekenwerk
Het standaard snelle prefillpad gebruikt 8-bit gewichten en 8-bit activaties in de trunk tijdens de promptverwerking. Dat verandert de rekenprecisie voor promptrijen. Het slaagde voor het KL-budget op de server en de opzoektests hierboven, maar de controle met lange documenten vond het niet bit-reproduceerbaar tussen runs.21
Het openbaar als exact aangeduide Gated DeltaNet-prefillpad blijft beschikbaar. Het behoudt de andere kwantisatiekeuzes en zet dus niet al het promptrekenwerk om naar BF16. Een meting op de ontwikkelstack gaf 7.607 tokens/s bij 64K, tegenover 8.161 voor het snelle pad van de release-image. Het exacte pad was bit-reproduceerbaar in de controles. Het is niet opnieuw gemeten op de release-image, dus dit is geen benchmarkvergelijking binnen dezelfde image. De keuze verandert het rekenwerk tijdens decode niet.1
| Instelling voor promptdiepte | Exacte GDN-prefill, ontwikkelstack |
|---|---|
| 2K | 7.575 tokens/s |
| 8K | 7.785 tokens/s |
| 16K | 7.762 tokens/s |
| 32K | 7.711 tokens/s |
| 64K | 7.607 tokens/s |
| 128K | 7.422 tokens/s |
Hoe we hebben gemeten
De belangrijkste tabellen gebruiken BetterBench 0.6.0, standaardprofiel, tegen de release-image via zijn eigen launcher en OpenAI-compatibele endpoint. De samplinginstellingen waren temperature 0,7, top-p 0,95 en top-k 20. Elke decodecategorie had 20 gemeten runs na drie opwarmruns; de gelijktijdigheidstest gebruikte 48 verzoeken bij 1, 2, 4 en 8 streams; prefill gebruikte acht runs per diepte en blokken van 2.048 tokens.1
De gewogen decodescore kent 30% toe aan code, 20% aan redeneren, telkens 15% aan proza en JSON, en telkens 10% aan bestandsbewerking en samenvatten. Chat en rekenen worden apart gemeten en hebben geen gewicht in die score.5
Elk benchmarkverzoek bevatte een unieke nonce, zodat de prefixcache koud bleef. Decode, korte-promptlatentie en gelijktijdigheid gebruiken de speculatieve modus met 98.304 tokens. Prefill gebruikt de modus met 200.000 tokens zonder speculatieve decode. De twee GPU's wisselden ongecomprimeerde BF16-activaties uit. De host was rustig, zonder builds of uploads, en opstarten duurde ongeveer drie tot vijf minuten, vooral voor het laden van gewichten. Compilecaches zitten in de image.12
Deze metingen beschrijven onze host, prompts en releaseconfiguratie. Ze meten geen energieverbruik van het volledige systeem, kosten per token of snelheidswinst tegenover een ander model. Het openbare benchmarkrapport bewaart de configuratie en gedetailleerde resultaten.
Probeer het op twee R9700-kaarten
Gebruik een Linux-host met twee Radeon AI PRO R9700-kaarten, een ROCm 10-hostdriver, Python 3, de Hugging Face CLI en Docker met toegang tot /dev/kfd en /dev/dri. Voorzie ruim systeemgeheugen bovenop de n-gram-tabel van 48,9 GiB en schijfruimte bovenop het checkpoint van 108 GiB. De 251 GiB van onze testhost is een gemeten configuratie, geen opgegeven minimumeis.2
De commando's hieronder leggen de openbare launcher vast en downloaden expliciet de volledige modelrevisie, inclusief de runtimedrafter. Dat is belangrijk: de automatische download van deze vastgelegde launcher verwijst nog naar een oudere modelrevisie. Download eerst de revisie hieronder en geef de map mee met --weights, in plaats van op de automatische download te vertrouwen. Heb je de pluginrepository al, gebruik dan een afzonderlijke checkout zonder lokaal werk te vervangen.23
git clone https://github.com/Eliovp-BV/paiton-vllm-plugin.git
cd paiton-vllm-plugin
git checkout be0f1a53bd60ab1bf77131121f9cacdcf46d2863
cd models/Qwen3.8-Flash-Next

export PAITON_FLASHNEXT_DIR="$PWD/model-cache/qwen38-flash-next-w3a8"
hf download EliovpAI/Qwen3.8-Flash-Next-W3A8-Paiton-RDNA4 \
  --revision 829b089bf6636af9ffed1f333b103e4e383f7b48 \
  --local-dir "$PAITON_FLASHNEXT_DIR"
(cd "$PAITON_FLASHNEXT_DIR" && sha256sum -c SHA256SUMS)

python3 launch-flashnext.py --weights "$PAITON_FLASHNEXT_DIR" --mode decode
De launcher kiest ghcr.io/eliovp/paiton-vllm-plugin:qwen38-flashnext-rocm10-vllm029-20261010-r1, vastgelegd via een digest in het runtimelockbestand. De modelspecifieke installatiehandleiding beschrijft de modi van de Python-launcher. Stop de draaiende server vóór je een andere modus kiest:
# 200K-context, speculatieve decode uit
python3 launch-flashnext.py --weights "$PAITON_FLASHNEXT_DIR" --mode prefill-long

# Exacte Gated DeltaNet-prefill, standaardcontext
python3 launch-flashnext.py --weights "$PAITON_FLASHNEXT_DIR" --mode decode-nopf

# 200K-modus met optionele prefixcaching
python3 launch-flashnext.py --weights "$PAITON_FLASHNEXT_DIR" \
  --mode prefill-long --prefix-caching
Start één modus tegelijk. prefill-long-nopf kiest het exacte Gated DeltaNet-prefillpad bij 200K; --dry-run toont het Dockercommando zonder de server te starten. Beide uitgebrachte basismodi gebruiken een BF16-attention-cache. Zodra de server klaar is, staat de endpoint op http://127.0.0.1:18982/v1, met modelnaam Qwen3.8-Flash-Next.2
Stuur in een andere terminal een streamingverzoek:
curl --fail http://127.0.0.1:18982/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3.8-Flash-Next","messages":[{"role":"user","content":"Write a short Python function that removes duplicates while preserving order."}],"temperature":0.7,"max_tokens":256,"stream":true}'
Gebruik voor dezelfde prestatietaken BetterBench 0.6.0 met het standaardprofiel tegen die endpoint, met de uitgebreide prefillmeting uit het releaserapport. Houd de resultaten voor decode- en prefillmodi gescheiden, zoals in de tabellen hierboven.
Wat volgt
De openbare roadmap omvat cachelagen in RAM en op SSD en een 4-bit build met hogere precisie. Ook beeldinvoer heeft eigen validatie nodig. Dit zijn volgende stappen, geen functies die de twee gevalideerde tekstmodi beloven.2
Voor nu is het resultaat een groter lokaal model met bruikbare generatiesnelheid, een gemeten 200K-optie en duidelijke kwaliteitsgrenzen, op twee workstation-GPU's. Reguliere vLLM, onze plugin, onze kernels.
Credits en licenties
Qwen3.8 Flash Next is van het Qwen-team. vLLM levert het serverframework, BetterBench de prestatietaken en Paiton de gekwantiseerde gewichten en native uitvoering in deze release.
Het upstreamcheckpoint gebruikt Qwen Community License 1.0, niet Apache-2.0. Daar horen voorwaarden voor commercieel gebruik bij. Bekijk de upstreamlicentie op de checkpointrevisie vóór inzet. De openbare pluginadapter, modelgewichten, verpakte runtime en propriëtaire compiler zijn afzonderlijke onderdelen met eigen voorwaarden. Dit artikel houdt geen onbeperkt commercieel hergebruik in.
Ontdek Paiton, lees de modelkaart en evaluatiedetails of neem contact op om een lokale AMD AI-werklast te bespreken.
Bronnen
- Release-imagebenchmarks van 10 oktober, vastgelegde checkout. 2 3 4 5 6 7 8 9 10 11 12
- Modelspecifieke release- en installatiehandleiding, vastgelegde checkout. 2 3 4 5 6 7 8 9 10 11 12
- Qwen3.8 Flash Next W3A8-modelkaart, vastgelegde revisie. 2 3 4 5 6 7 8 9 10 11 12 13 14
- Openbaar kwaliteitsrapport, vastgelegde modelrevisie.
- BetterBench 0.6.0-taakgewichten, vastgelegde standaardinstellingen.