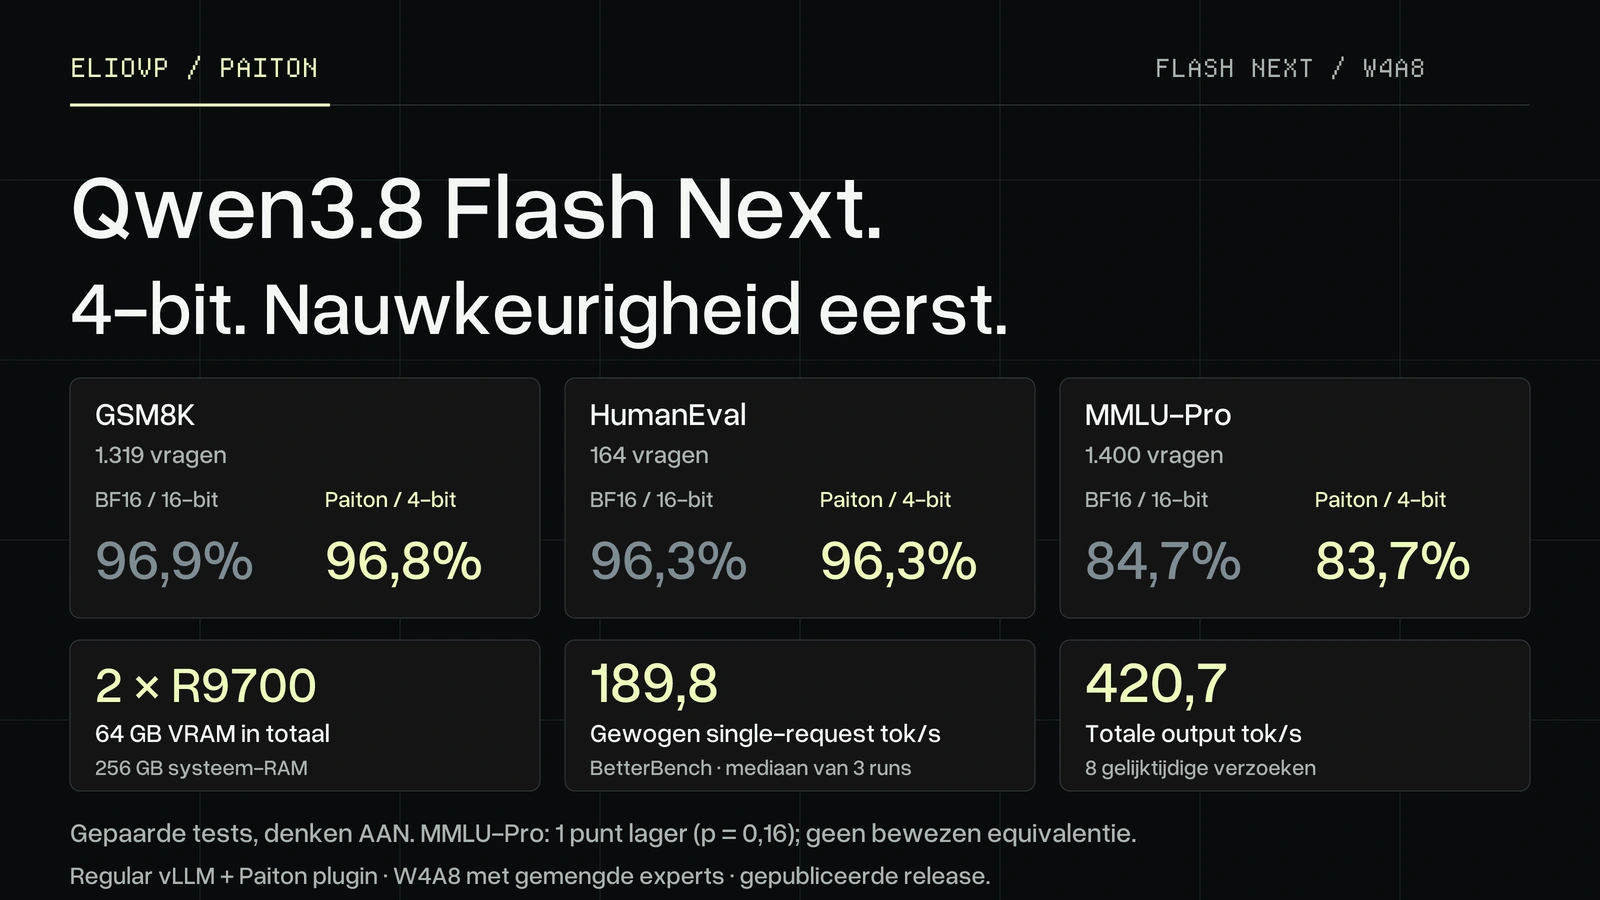
Het 16-bit checkpoint van Qwen3.8 Flash Next is 360 GB. Twee Radeon AI PRO R9700-kaarten hebben samen 64 GB VRAM, dus het originele model past daar bij lange na niet op. Onze nieuwe 4-bit release draait op die twee kaarten, met resultaten dicht bij de 16-bit referentie op rekenen, Python-code en kennistaken.1
Het praktische resultaat: 189,8 tokens/s voor gewogen generatie met één verzoek, 420,7 tokens/s bij acht gelijktijdige verzoeken, en een optionele RAM-prefixcache voor lange codegesprekken. Het blijft gewone vLLM met de Paiton-plugin en onze eigen kernels. De gemeten opstelling vraagt een host met 256 GB RAM, omdat minder gebruikte experts en grote tabellen in systeemgeheugen staan.2
Dit volgt op onze 3-bit Flash Next-release. Hier ligt de prioriteit bij het behouden van meer van de kwaliteit van het oorspronkelijke model.
Nauwkeurigheid tegenover het 16-bit model
We lieten beide modellen dezelfde vragen beantwoorden, met dezelfde prompts, samplingseeds per vraag en chattemplate met thinking aan. Het 4-bit model gebruikte de uitgebrachte serving-modus 4bit; de 16-bit referentie gebruikte het originele checkpoint.1
Taaknauwkeurigheid; hoger is beter. GSM8K en HumanEval gebruiken hun volledige testsets. MMLU-Pro gebruikt een vaste subset van 1.400 vragen, 100 per categorie voor alle 14 categorieën. HumanEval is pass@1. Beide modellen hebben een antwoordlimiet van 16.384 tokens.
| Taak | Vragen | 16-bit | Paiton 4-bit |
|---|---|---|---|
| GSM8K, rekenen | 1.319 | 96,9% | 96,8% |
| HumanEval, Python-code | 164 | 96,3% | 96,3% |
| MMLU-Pro, kennis | 1.400 | 84,7% | 83,7% |
GSM8K verschilt met 0,1 procentpunt; HumanEval is gelijk. Met een tweede reeks seeds veranderde het 16-bit model zelf met 0,0 punten op GSM8K en 1,2 punten op HumanEval. De gepaarde toetsen voor beide gekwantiseerde vergelijkingen geven p = 1,00.1
MMLU-Pro ligt één punt lager voor het 4-bit model, met een gepaard 95%-interval van −2,3 tot +0,3 punten en p = 0,16. Dat bewijst geen statistische gelijkwaardigheid. Meer 4-bit antwoorden bereikten de antwoordlimiet: 104 tegenover 79. Op de 1.271 vragen waarbij geen van beide modellen die limiet bereikte, zijn de scores 91,1% voor 4-bit en 91,0% voor 16-bit. Die subset helpt het verschil te beschrijven, maar bewijst niet dat een langere limiet het zou wegnemen.1
Meer dan alleen taakscores
Taakscores kunnen verschillen in tokenvoorspellingen verbergen. Daarom maten we ook perplexiteit, negatieve log-likelihood bij lange documenten en KL-divergentie over de volledige woordenschat tegenover BF16, de 16-bit referentie.1
Toename in perplexiteit tegenover BF16; lager is beter. De twee contextlengtes worden apart geëvalueerd. KL is een andere maat: het gemiddelde verschil tussen de kansverdelingen voor het volgende token op 170.884 tekst- en assistentposities, waarbij elk model zijn eigen experts kiest. KL nul zou identieke verdelingen betekenen.
| Tekst en contextlengte | Perplexiteit 16-bit | Perplexiteit 4-bit | Toename |
|---|---|---|---|
| WikiText-2-test, 512 tokens | 4,589 | 4,629 | 0,87% |
| WikiText-2-test, 4.096 tokens | 3,929 | 3,961 | 0,80% |
| Ongeziene tekst, 512 tokens | 6,938 | 6,954 | 0,23% |
| Ongeziene tekst, 4.096 tokens | 6,163 | 6,187 | 0,38% |
De ongeziene tekst bevat 22 documenten, samen 262.144 tokens, die nooit zijn gebruikt om de kwantisatie te maken. Perplexiteit gebruikt ruwe tekst zonder chattemplate en scoort de tweede helft van elk contextblok.1
| Configuratie | Bits per routed-expertgewicht | KL tegenover BF16 |
|---|---|---|
| Twee correcte BF16-implementaties | 16 | 0,0077 |
| Paiton 4-bit, INT6-trunk en FP8-cache | 3,926 | 0,0306 |
| Standaard MXFP4-referentie, 8-bit trunk en BF16-cache | 4,25 | 0,0515 |
De MXFP4-rij is onze eigen meting op dezelfde experts, geen andere serving-engine. De geserveerde 4-bit configuratie heeft 41% lagere KL en ongeveer 8% minder bits per expertgewicht, inclusief schalen. Ook de trunk en cache verschillen, dus dit isoleert niet het effect van het gewichtsformaat en betekent geen 41% hogere taaknauwkeurigheid.1
Over 44 apart gehouden documenten van 8K tot 32K tokens ligt de negatieve log-likelihood binnen 0,16% van BF16. Een needle-opzoektest bij 131.072 tokens geeft 40 op 40, met alle 419 antwoordtokens gelijk aan de referentie.1
Deze verdelings- en opzoekcontroles emuleren het standaard geserveerde rekenpad: INT6-trunk, int8-promptactivaties en FP8-KV-cache. De taakbenchmarks hierboven lopen via de server. De aparte 200K-modus gebruikt een 8-bit trunk en is niet afzonderlijk op nauwkeurigheid getest.1
Bruikbare snelheid op twee workstation-GPU's
De gepubliceerde prestatiemetingen gebruiken BetterBench 0.6.0, standaardprofiel, via de exacte release-image en launcher, op twee R9700-kaarten in een PCIe 4.0 x16-host met 251 GiB RAM.2
Gegenereerde tokens per seconde; hoger is beter. Het cijfer voor één verzoek is een gewogen decodescore. Het cijfer voor acht verzoeken is de gezamenlijke serverdoorvoer uit een aparte gelijktijdigheidstaak, geen snelheid per gebruiker of vergelijking van achtvoudige schaalbaarheid.
| Meting | Resultaat |
|---|---|
| Gewogen decode met één verzoek, mediaan van drie runs | 189,8 tokens/s |
| Acht gelijktijdige verzoeken, samen | 420,7 tokens/s |
| Tijd tot eerste token bij korte prompts, mediaan | 121 ms |
Alle 48 van 48 verzoeken werden afgerond bij gelijktijdigheid acht. BetterBench meet acht decodecategorieën, maar de gewogen score combineert er zes: code 30%, redeneren 20%, proza en JSON elk 15%, bestandsbewerking en samenvatten elk 10%. Chat en rekenen worden gemeten zonder bij te dragen aan die score.23
Lange prompts
Prefill is het lezen van de invoer voordat het model begint te antwoorden. De lange-contextmodus verwerkt de nominale 64K-promptdiepte met 6.991 invoertokens/s. Een aparte controle met koude cache en precies 64.000 prompttokens meet 7.162 tokens/s.2
Verwerkte invoertokens per seconde; hoger is beter. De BetterBench-promptdieptes zijn nominale instellingen, geen exacte tokenaantallen. Deze rijen gebruiken 4bit-200k, met een venster van 200.000 tokens en speculatieve decode uit. Ze staan los van de standaard decodemetingen.
| Instelling voor promptdiepte | Invoertokens/s |
|---|---|
| 2K | 5.564 |
| 8K | 6.771 |
| 16K | 6.641 |
| 32K | 7.044 |
| 64K | 6.991 |
| 128K | 6.857 |
| Modus | Contextvenster | Speculatieve decode | Gedeelde KV-cachecapaciteit |
|---|---|---|---|
4bit, standaard | 98.304 tokens | Aan, diepte 3 | 305.338 tokens |
4bit-200k | 200.000 tokens | Uit | 247.058 tokens |
Beide gebruiken een FP8 E4M3-KV-cache. De cachecapaciteit is gedeeld over verzoeken; ze is niet het maximale venster van één gesprek. In elk venster moeten de prompt, chatopmaak en het gegenereerde antwoord samen passen.14
Sneller herhaalde gesprekken met de RAM-prefixcache
Codeagents sturen bij elke beurt hun hele gesprek opnieuw. De optionele 4bit-cache-modus hergebruikt ongewijzigde prefixes in blokken van 2.048 tokens en bewaart uit VRAM verwijderde prefixblokken in een 8 GiB pinned RAM-laag.2
Tijd tot eerste token in aparte cachecontroles met herhaalde prompts; lager is beter. Een cachehit vraagt een herbruikbare prefix die nog in de cache staat. Dit zijn niet de BetterBench-prefillmetingen met koude cache.
| Herhaalde prompt | Eerste token zonder cachehit | Cachehit uit RAM-laag |
|---|---|---|
| 32K | 6,3 s | 1,0 s |
| 64K | 12,3 s | 1,1 s |
| 90K | 16,2 s | 1,1 s |
De geteste RAM-hits geven identieke uitvoer als een koude start. Daar staat ongeveer 22% minder multi-userdoorvoer tegenover in de cachemodusvalidatie: 321,4 tegenover 411,3 tokens/s samen. Die validatiebaseline staat los van het BetterBench-hoofdcijfer van 420,7. Nieuwe prompts beginnen ook 0,1 tot 0,2 seconden later.24
De volledige RAM-laag vraagt ongeveer 108 GiB vrije GTT, inclusief het extra pinned geheugen. Bij minder vrije GTT waarschuwt de launcher en verkleint of schakelt hij de RAM-laag uit, met behoud van prefixcaching in VRAM. Kies expliciet 4bit-cache; de gewone modi 4bit en 4bit-200k weigeren --prefix-caching.25
Wat 4-bit hier betekent
Flash Next is een mixture-of-expertsmodel. In elke laag gebruiken de 410 meest gebruikte experts INT4, met GPTQ gekalibreerd in een geroteerde basis. De 102 minst gebruikte experts gebruiken het 3-bit codebookformaat uit onze eerdere release. Samen komen de routed experts uit op gemiddeld 3,926 bits per gewicht, inclusief schalen. Dat gemiddelde geldt voor de gemengde expertset, niet voor het 3-bit formaat alleen.1
De standaard serving-modus gebruikt een 6-bit trunk, terwijl andere onderdelen 8-bit of hogere precisie behouden. De MTP-laag stelt speculatieve tokens voor die het doelmodel controleert. Het model is niet overal vier bits.1
Dit werk kostte ongeveer 250 GPU-uren op een AMD Instinct MI355X-systeem voor kwantisatie, tuning en nauwkeurigheidstests, plus ongeveer 100 uur op de twee R9700-kaarten voor tests van het geserveerde model. Die schattingen omvatten onze 3-bit en 4-bit Flash Next-releases samen.
De volledige 4-bit expertset past niet naast de runtime en cache op twee 32 GB-kaarten. Ongeveer 20,8 GiB experts per kaart blijft in VRAM; de GPU's lezen de rest uit pinned systeemgeheugen wanneer nodig. De launcher pint in totaal ongeveer 96 GiB, zo'n 55 GiB voor tabellen en 41 GiB voor expertkopieën. De geheugenbandbreedte en PCIe-verbindingen van de host zijn dus belangrijk.2
De gemeten opstelling gebruikt GPU-gemapte GTT-geheugenallocaties, met ongeveer 98 GiB vrije GTT nodig als basis. Daarom specificeren we een host met 256 GB. Bij minder GTT kan de launcher terugvallen op ROCm user-pointergeheugen, met een waarschuwing over lagere snelheid en mogelijke pauzes tijdens geheugencompactie op de host. Hij verandert geen kernelgeheugenlimieten.2
Start de release
Gebruik Linux x86-64, twee Radeon AI PRO R9700-kaarten, een ROCm 10-hostdriver, Docker met toegang tot /dev/kfd en /dev/dri, en Python 3.10 of nieuwer met huggingface_hub geïnstalleerd. Voorzie 133 GB voor gewichten, plus de runtime-image van ongeveer 41 GB en werkruimte.6
De commando's leggen de launcher vast en downloaden eerst de volledige modelrevisie. Dat vermijdt een probleem bij de eerste start in deze launcher: hij controleert de drafter vóór zijn automatische download. Gebruik een nieuwe checkout als je al lokale pluginwijzigingen hebt.5
git clone https://github.com/Eliovp-BV/paiton-vllm-plugin.git
cd paiton-vllm-plugin
git checkout a985fa598d9a3c7536720304830a0e427f3af1f2

python3 -m venv .venv
. .venv/bin/activate
python3 -m pip install huggingface_hub
python3 - <<'PY'
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id="EliovpAI/Qwen3.8-Flash-Next-W4A8-Paiton-RDNA4",
    revision="9ec8e306503d5f9c9e8fd9c0d77de8fa63428888",
    local_dir="flashnext-w4a8",
)
PY
(cd flashnext-w4a8 && sha256sum -c SHA256SUMS)

python3 models/Qwen3.8-Flash-Next/launch-flashnext.py \
  --mode 4bit --weights "$PWD/flashnext-w4a8" --dry-run
bash models/Qwen3.8-Flash-Next/run-flashnext-4bit.sh \
  --weights "$PWD/flashnext-w4a8" --host 127.0.0.1
De dry run toont RAM, GTT-limieten en GPU-verbindingscontroles. De launcher haalt de runtime op via digest. Na de gewichtendownload duurt de eerste start ongeveer vijf tot zes minuten; wacht op launcher: READY on port …. De API staat op http://127.0.0.1:18982/v1, met modelnaam Qwen3.8-Flash-Next.64
De standaardserver luistert op alle netwerkinterfaces zonder API-sleutel. Het voorbeeld beperkt dat tot localhost. Beveilig toegang voor vertrouwde externe clients met een firewall of stel PAITON_API_KEY in de omgeving in. Verkies de omgevingsvariabele boven --api-key, die de sleutel zichtbaar maakt in de proceslijst.6
Stop de draaiende server voordat je een andere modus kiest:
# 200K-venster, speculatieve decode uit
bash models/Qwen3.8-Flash-Next/run-flashnext-4bit-200k.sh \
  --weights "$PWD/flashnext-w4a8" --host 127.0.0.1

# Herhaalde codegesprekken, optionele RAM-prefixcache
bash models/Qwen3.8-Flash-Next/run-flashnext-4bit-cache.sh \
  --weights "$PWD/flashnext-w4a8" --host 127.0.0.1
De 4-bit installatiehandleiding beschrijft de opties. Deze gewichten vragen de Paiton-runtime en plugin; standaard modelloaders ondersteunen het formaat niet.1
Ook in deze release
De 3-bit Flash Next-launcher krijgt een stabielere start op drukke hosts, controles voor GPU-verbindingen en hostgeheugen, en expliciete prefixcacheblokken van 2.048 tokens. De standaardbinding aan alle interfaces en optionele API-sleutel gelden voor beide releases. De 3-bit gewichten en runtime-image zijn ongewijzigd.7
Qwen3.8 27B op één R9700 krijgt ook een launcherupdate. Zijn 3-bit --mode long houdt nu 316.325 tokens gedeelde cache vast, en de opstartgeheugenpieken zijn lager in de 3-bit modi. De MXFP4-configuraties zijn ongewijzigd.8
Op weg naar hosts met 128 GB
Niet iedereen heeft 256 GB RAM. We werken aan een 4-bit configuratie die de grote n-gram-tabel in gewoon, niet-gepind geheugen houdt, met als doel bit-identieke uitvoer te behouden. Het doel is machines met 128 GB. Dit is werk in uitvoering, geen uitgebrachte of gekwalificeerde configuratie.
Credits en licenties
Qwen3.8 Flash Next is van het Qwen-team; vLLM levert het serving-framework en BetterBench de prestatietests. De modelgewichten blijven onder Qwen Community License 1.0, met voorwaarden voor commercieel gebruik. Bekijk de upstreamlicentie vóór inzet.
Lees de 4-bit modelkaart en nauwkeurigheidsdetails, ontdek Paiton, of neem contact op over een lokale AMD-AI-workload.
Bronnen
- W4A8-modelkaart en evaluatiemethoden, vastgelegde revisie. 2 3 4 5 6 7 8 9 10 11 12 13
- 4-bit nauwkeurigheid, snelheid en hardware, vastgelegde release. 2 3 4 5 6 7 8 9
- BetterBench 0.6.0-workloadgewichten.
- Vastgelegde gewichten, runtimedigest en serving-modi. 2 3
- Publieke launchercontroles en RAM-laagdimensionering, vastgelegde release. 2
- Launchervoorwaarden en netwerkconfiguratie, vastgelegde release. 2 3
- Flash Next-releasenotities, vastgelegde release.
- 27B 3-bit launcherupdate van 11 oktober, vastgelegde release.